Imagem
GPT Image 2.5 Sunburst Text to Image Variantes: 4
≈ $ 0,054
54 créditos de API
Nenhum resultado. Tente “vídeo”, “FLUX” ou “webhooks”.
Carregando modelos…
openai/gpt-image-2.5/flare/text-to-image
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/pt-BR/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.com/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
}Chame o modelo GPT Image 2.5 Text to Image (openai/gpt-image-2.5/flare/text-to-image) por meio da Doitong API. Documentação para agentes: https://doitong.com/pt-BR/developers/models/openai/gpt-image-2.5/flare/text-to-image.md
POST https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
Se o status da resposta for "queued" ou "running", consulte GET https://api.doitong.com/v1/requests/REQUEST_ID?wait=20 repetidamente até que seja "succeeded"; os arquivos estão em outputs[].url. POST https://api.doitong.com/v1/quote/openai/gpt-image-2.5/flare/text-to-image com o mesmo corpo retorna o preço exato antes da execução.Esta solicitação: $ 0,013 13 créditos de API Executar nesta página
Sua nova chave de API. Ela é exibida apenas agora e já está no código e no campo de chave de API abaixo. Mantenha-a em segredo: nunca a coloque em um código executado no navegador.
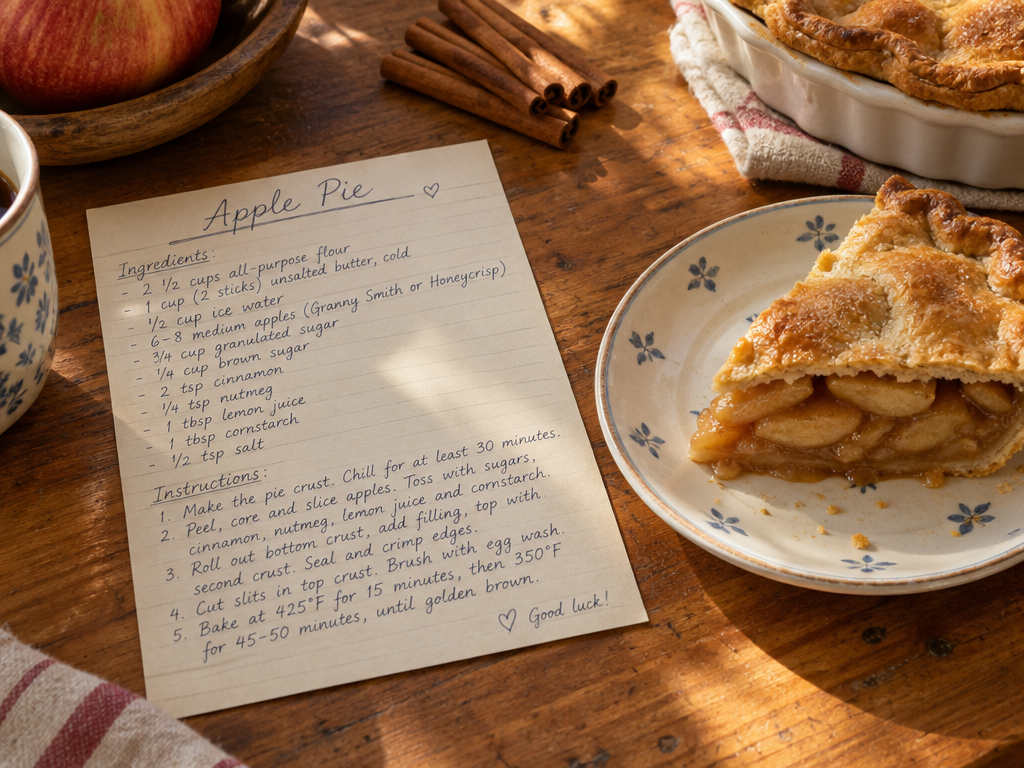
Os controles são gerados a partir do esquema do modelo. O código e o preço são atualizados conforme você os altera.
/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
cotação → $ 0,013
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
},
"wait_seconds": 20
}
}
}Sua chave permanece neste navegador: ela é enviada somente à Doitong API e salva (localStorage) apenas se você marcar Lembrar. Obter uma chave de API
Trabalhos públicos feitos com GPT Image 2.5 pela comunidade Doitong. Reutilize um prompt com um clique.
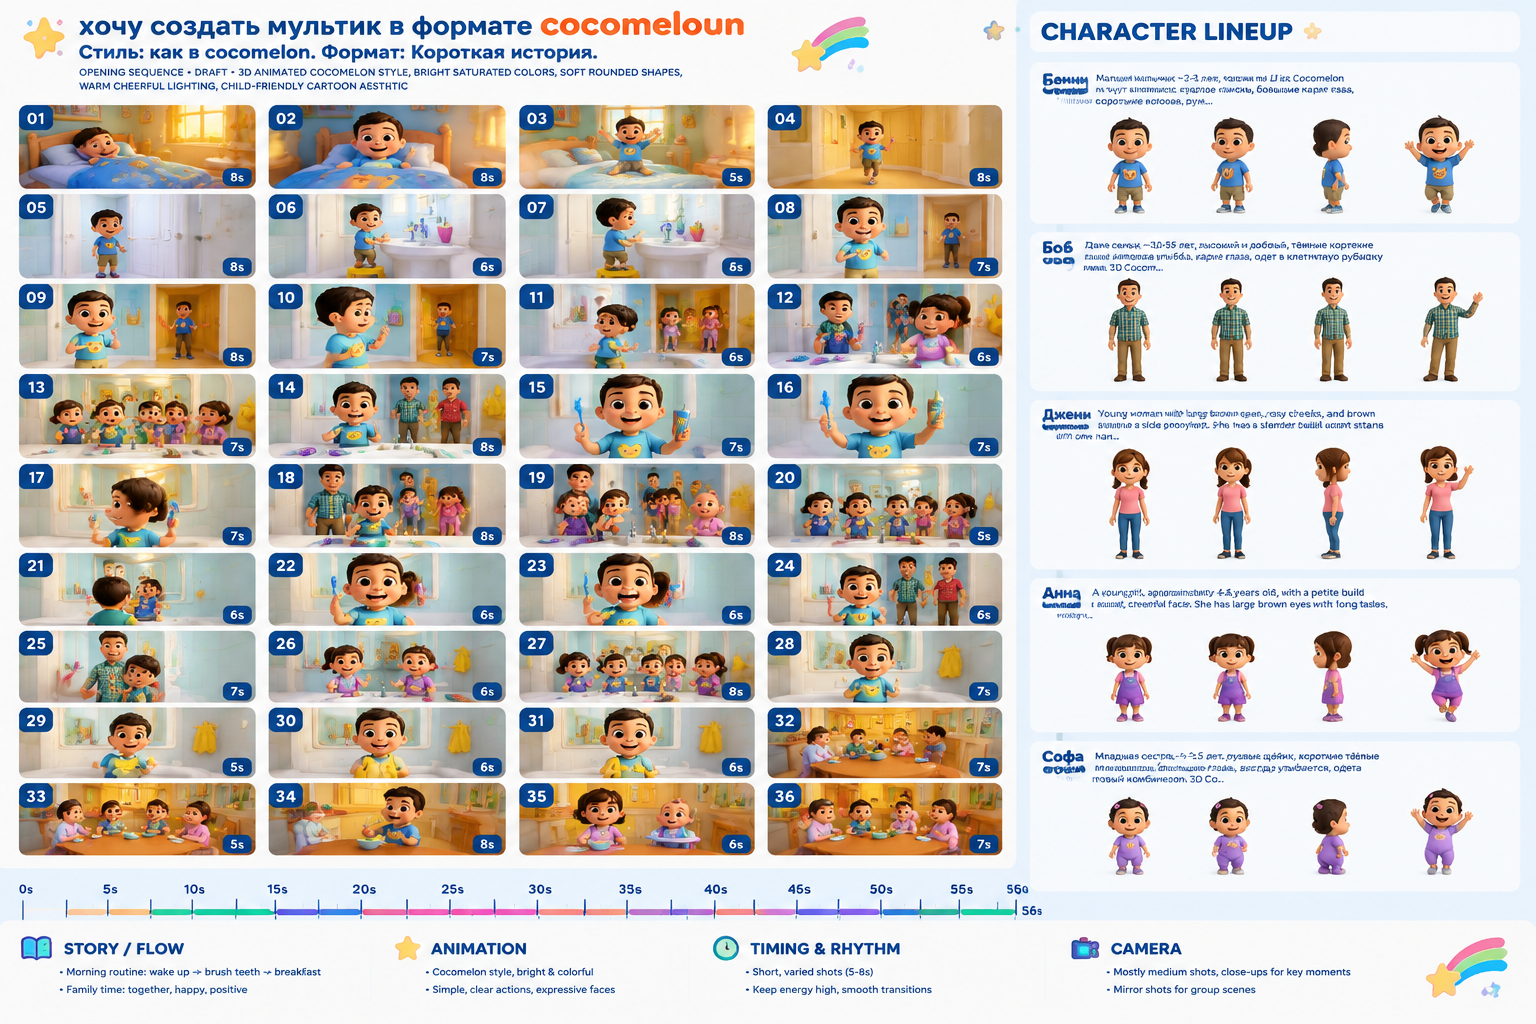
A polished studio concept art board — a single composite page that reads as a high-end pre-production pitch deck for an animated short. NOT a vintage pencil sketch, NOT a finished movie frame, but a polished concept page in the visual treatment described below. Layout: TOP HEADER (left): bold...
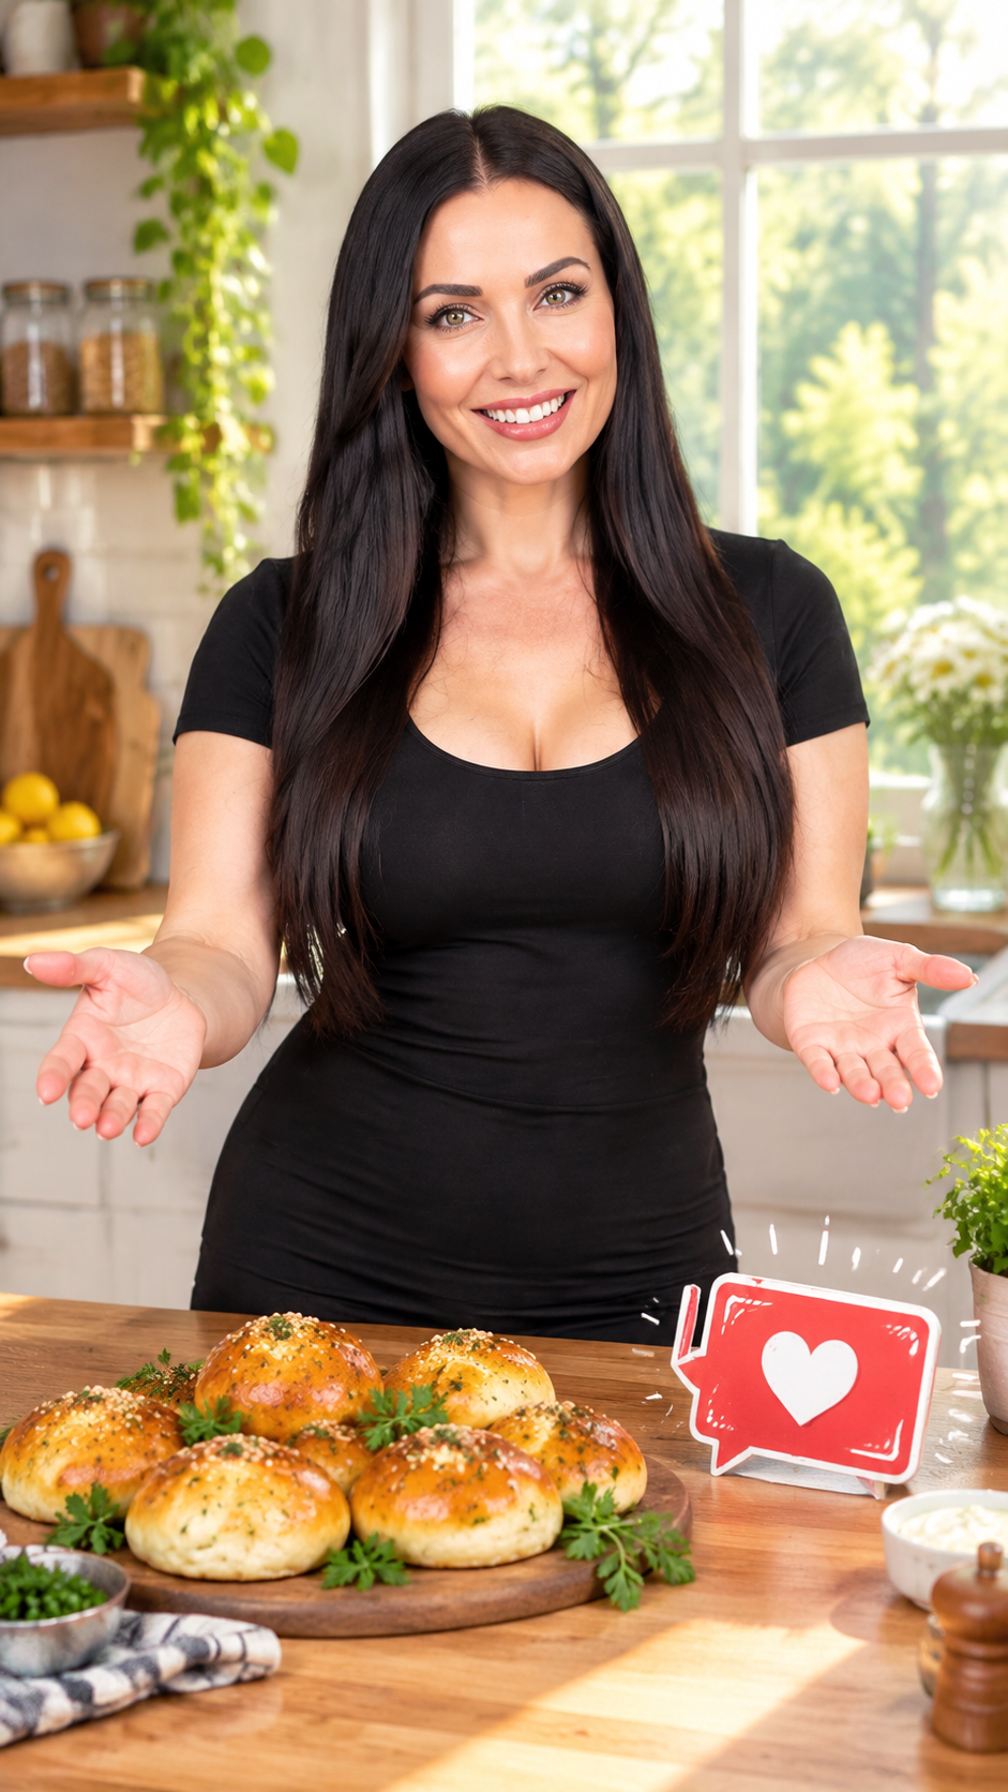
Art style: Реалистичный кулинарный блог. Финальный кадр, средний план ведущей. Она улыбается своей самой широкой и дружелюбной улыбкой, глядя в камеру. Она делает призывающий жест руками, словно приглашая к общению. Перед ней на столе по-прежнему лежат аппетитные булочки. Освещение становится...
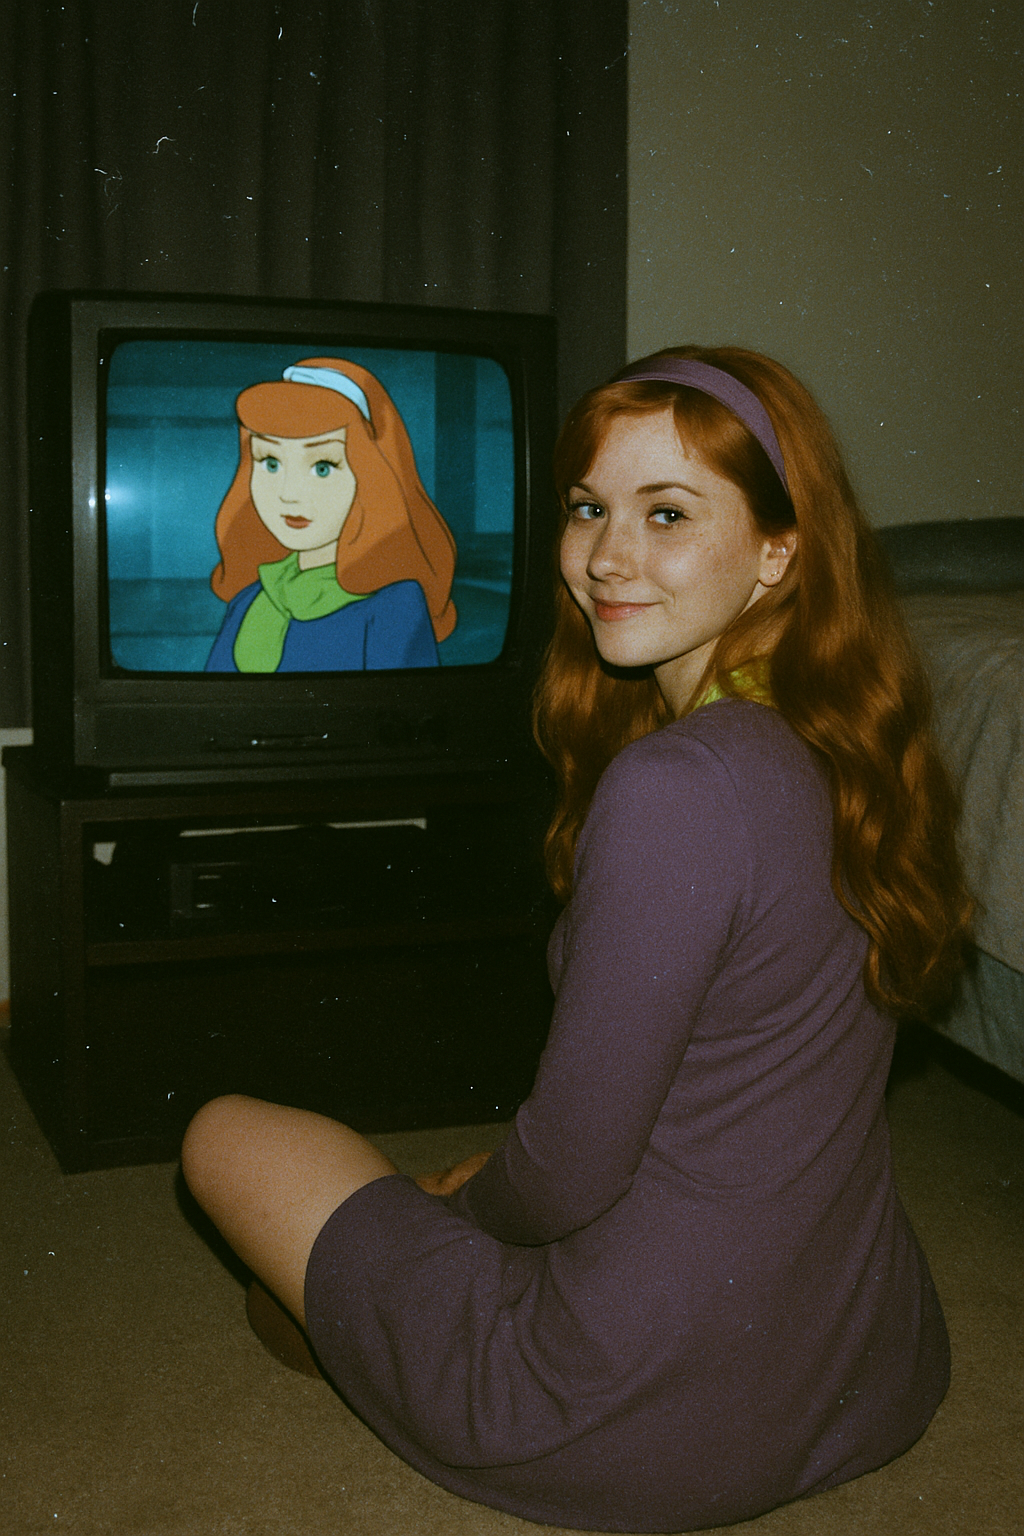
Grungy analog photo of Daphne Blake (from Serial scooby doo) watching her own movie on a 90s CRT TV in a dimly lit bedroom. The TV clearly shows animated scene from scooby doo, with a cartoon-style Daphne in her classic clothes on screen, smiling. Daphne Blake is sitting cross-legged on the floor...
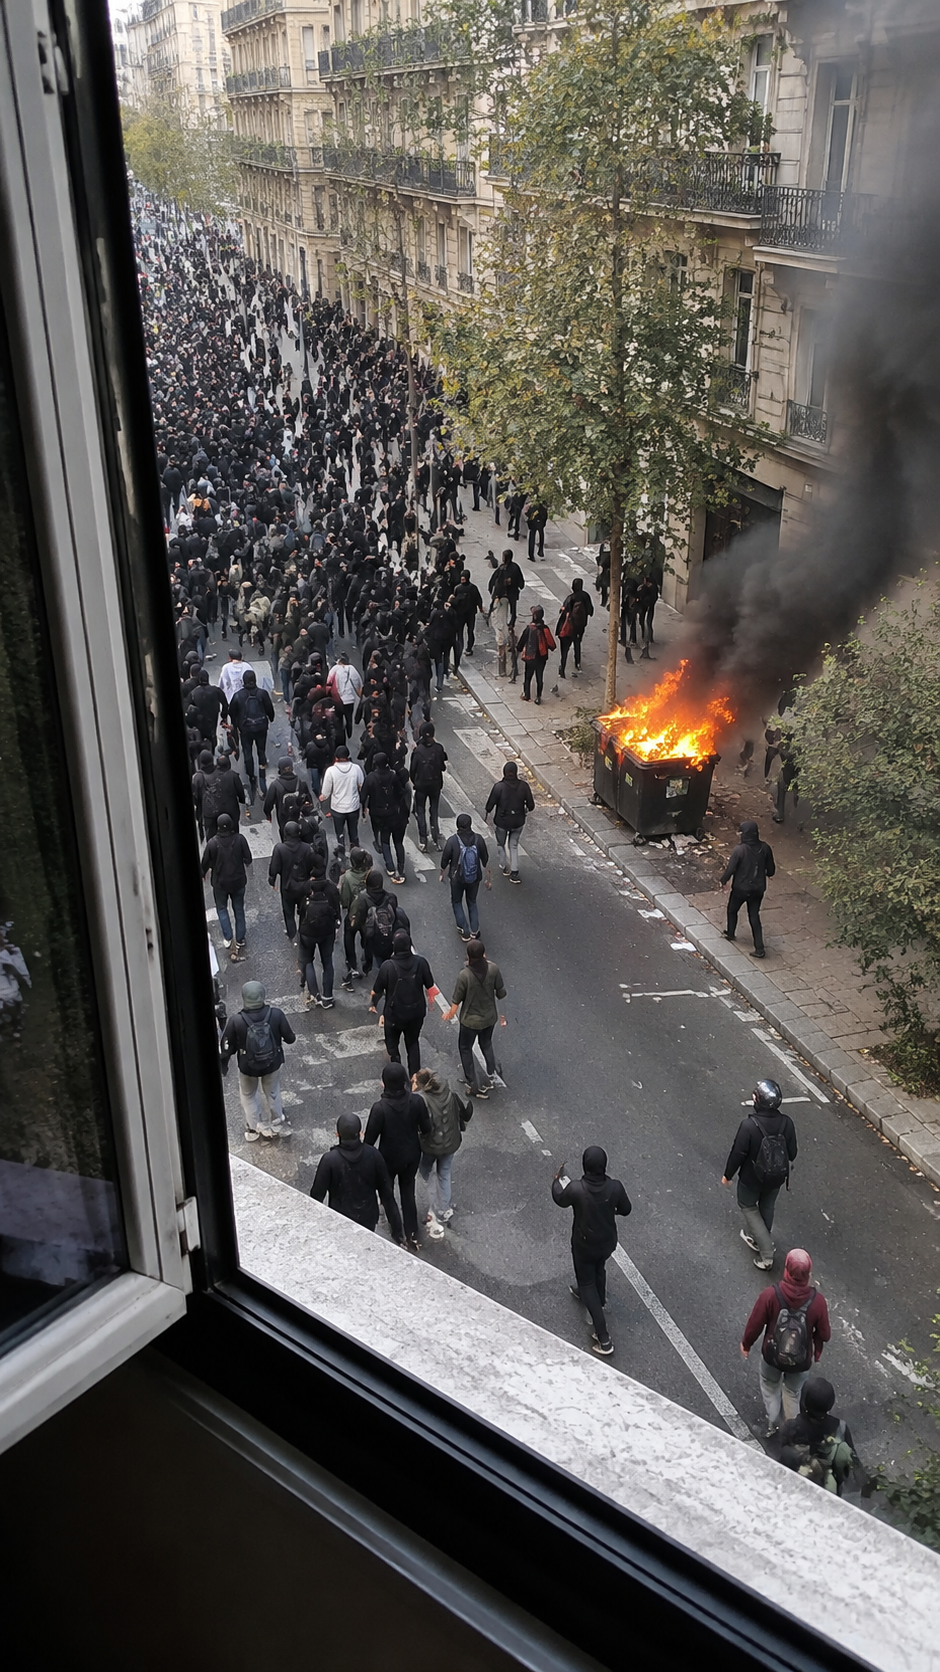
Fotografia realistica scattata dall’interno di un appartamento situato a un piano abbastanza alto, guardando verso il basso attraverso una finestra aperta su una normale strada cittadina. In strada, una folla numerosa di manifestanti avanza compatta; alcune persone indossano passamontagna. Sul...
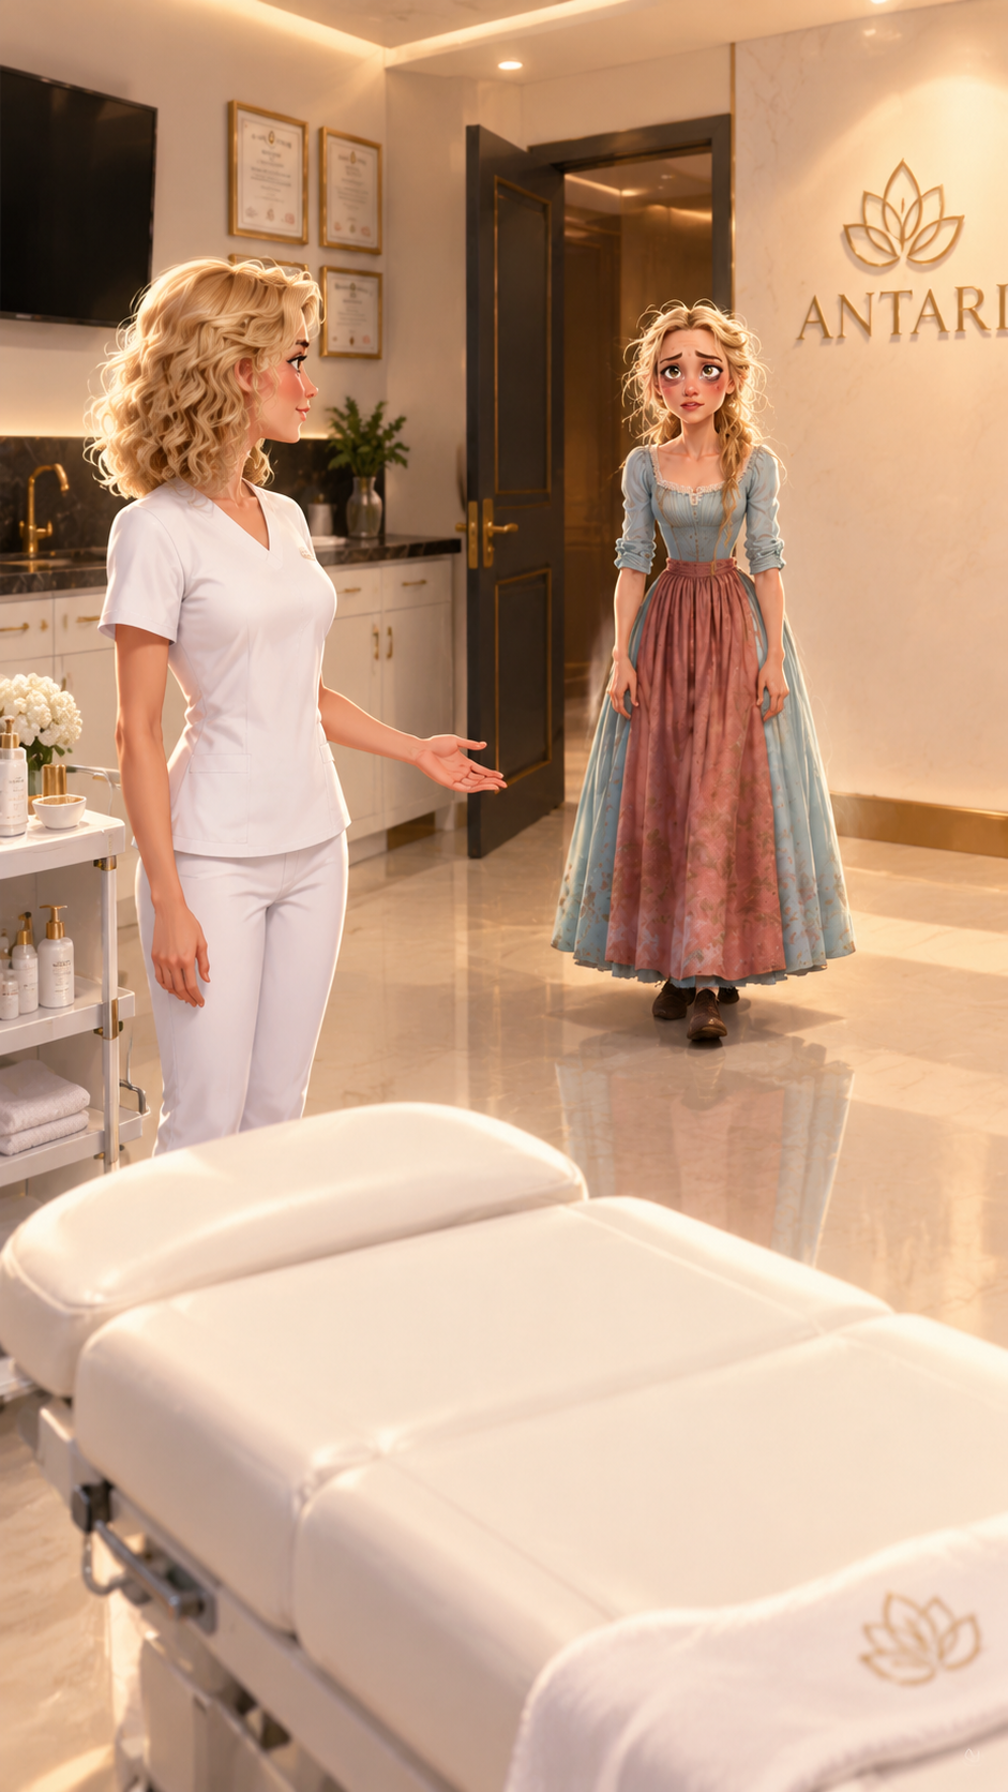
Art style: Disney-inspired. Золушка walking further back in the frame; Косметолог standing in the near foreground. The couch and strip of reflective floor separate them. Золушка is walking on glossy floor near the open doorway further back in the frame in the midground. Torso in three-quarter...
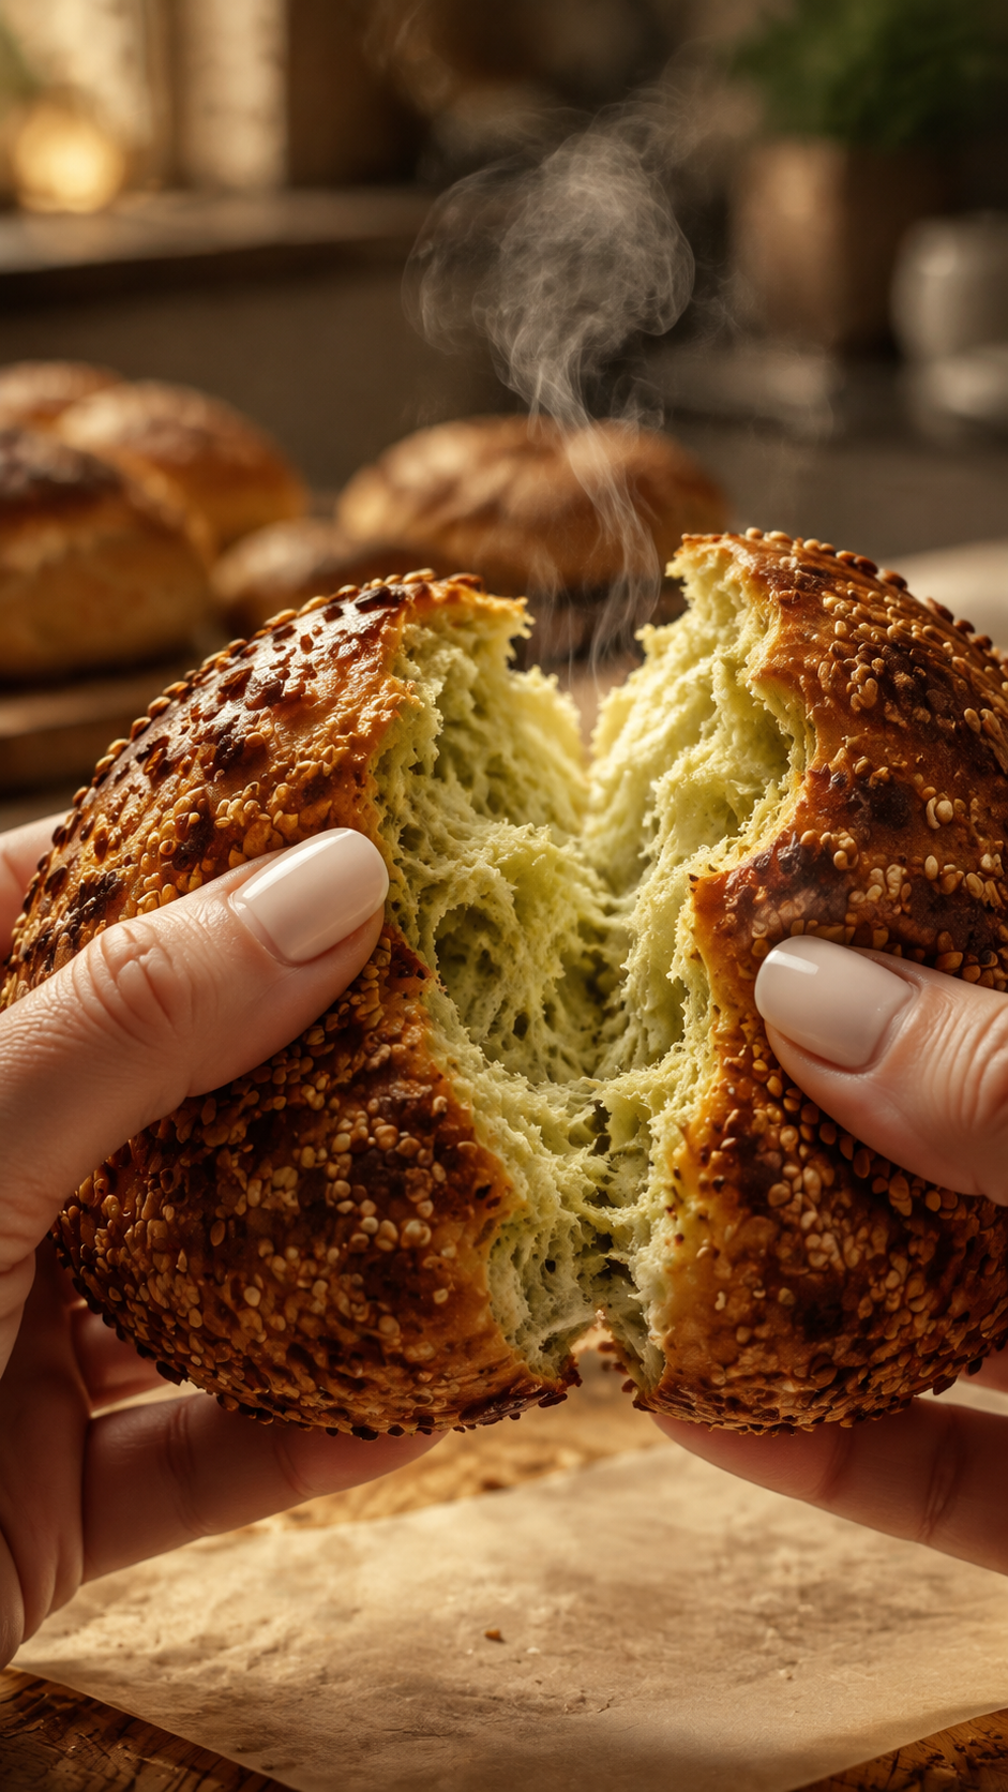
Art style: Реалистичный кулинарный блог. Экстремально крупный план рук ведущей, разламывающих готовую, горячую булочку. Булочка имеет аппетитную золотисто-коричневую корочку, густо посыпанную поджаренным кунжутом. В месте разлома видна пористая, воздушная и очень мягкая текстура мякиша...
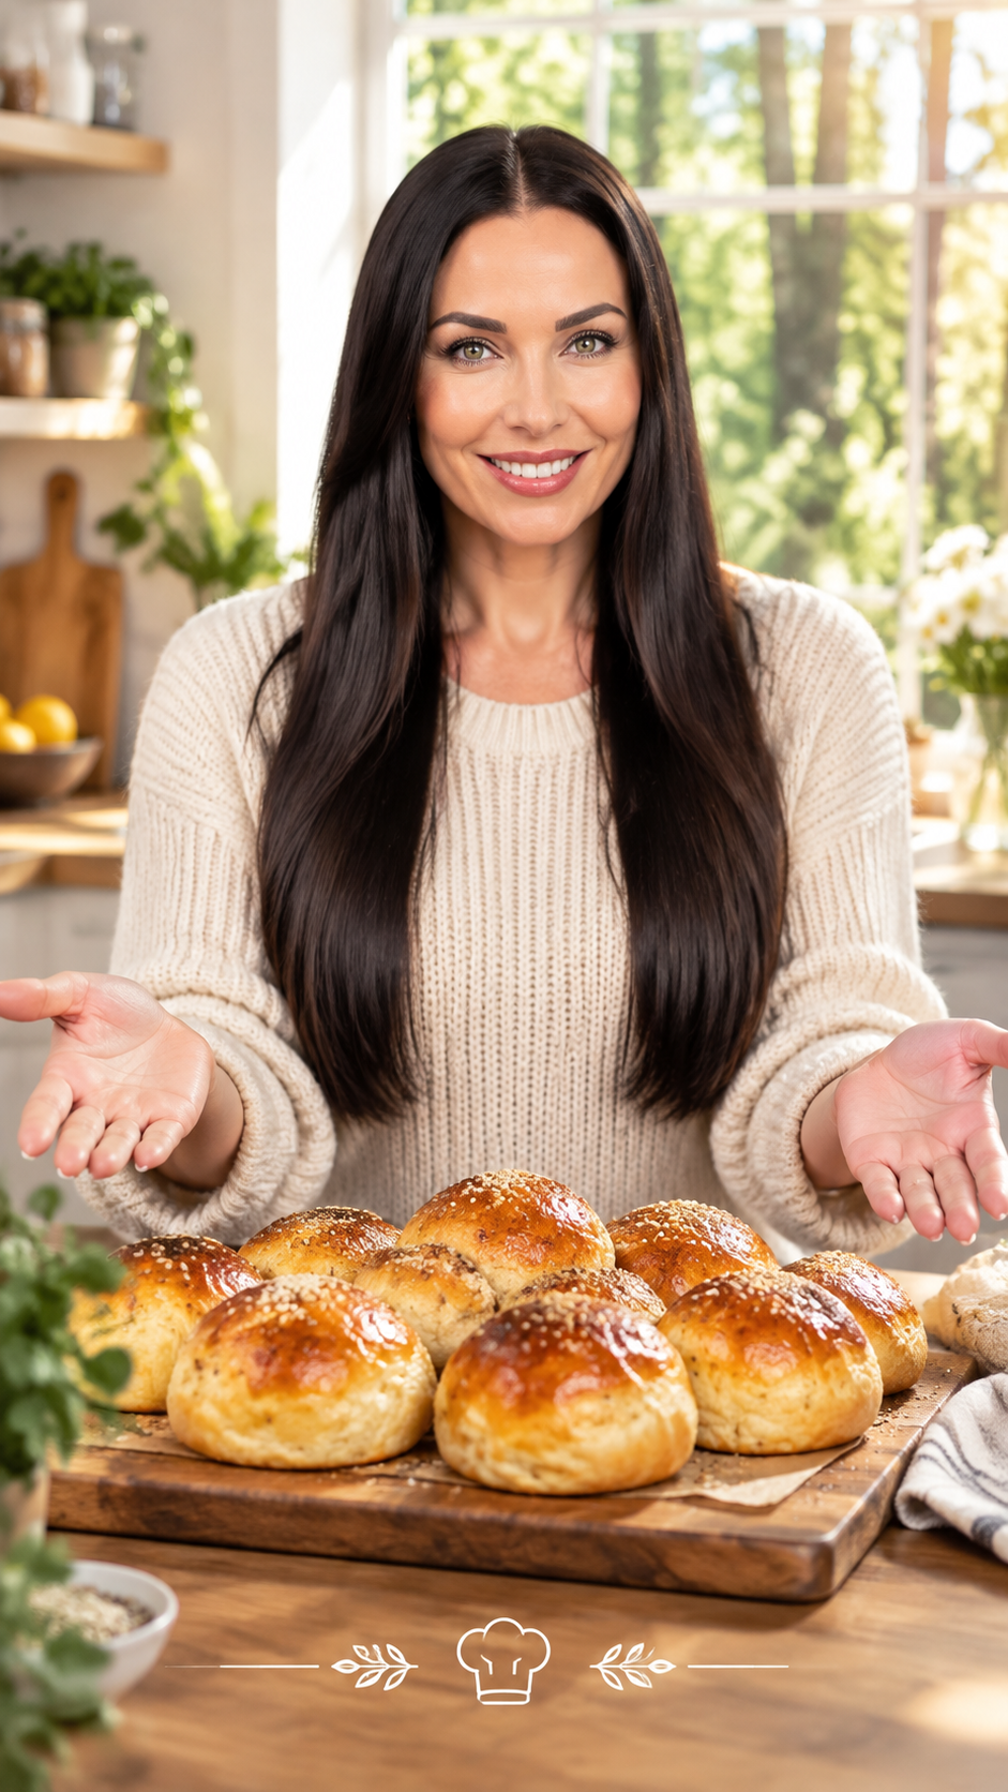
Art style: Реалистичный кулинарный блог. Финальный кадр, средний план ведущей. Она улыбается своей самой широкой и дружелюбной улыбкой, глядя в камеру. Она делает призывающий жест руками, словно приглашая к общению. Перед ней на столе по-прежнему лежат аппетитные булочки. Освещение становится...
Square album cover for an energetic house dance single. A dancing crowd silhouette in a night club under warm orange and golden stage lights, flying sparks and flames rising from the dance floor, misty Scottish highland mountains faintly visible in the glowing background. Bold modern clean...
Medium shot of launch team executives in smart casual blazers over plain t-shirts, sitting in a modern conference room facing a large display showing the 'International AI Safety Report' document title from February 2026, professional lighting. Context markers: smart casual blazer, plain t-shirt,...
Art style: DreamWorks-inspired. Zolushka lying in the middle ground; kosmetolog leaning further back in the frame. Zolushka is lying on белая кушетка in the middle ground in the foreground. Head facing camera. Eyes on потолок. Руки вне фокуса вдоль тела. Усталость и бессилие. Zolushka wears образ...

Use facial feature of attached photo. A realistic portrait of a woman with black hair loosely tied back, sitting outside a whitewashed stone house with a conical roof in a quiet Italian village. She wears a soft yellow floral summer dress with puff sleeves and white strappy heels. A wicker basket...

Art style: Кинематографичный, реалистичная съемка. Узкая улочка в Мумбаи ранним утром. В воздухе висит легкий туман. Арджун, молодой человек, стоит у небольшой чайной будки. Он держит стаканчик с чаем и широко улыбается, только что угостив всех вокруг. Атмосфера теплая и дружеская....

Real photo retouching of existing room, medium warm grey walls, white rectangular panel wall mouldings in classic grid pattern, same moulding layout as original photo, warm oak hardwood plank floor, brass gold straight track lighting rail on white ceiling with multiple adjustable spotlights,...

2D flat animation character design reference sheet for an advanced AI assistant avatar, hybrid of The Simpsons and lo-fi indie cartoon. Use the attached visual reference as the primary shape guide for head construction, optics, and premium engineering vibe. Clear black outlines (not too thick),...
Art style: Реалистичный кулинарный блог. A clearly recognizable likeness of Ведущая — keep their real face shape, skin tone, hairstyle, build and any signature look (hair, kit, number). Молодая женщина лет 38-41 с темными каштановыми волосы длинные распущенные по плечам вниз легкий макияж, одета...
Art style: Реалистичная китайская дорама, кинематографичная съёмка, живые городские локации, выразительные крупные планы; драматический абсурд с комедийными паузами. Атмосфера шумного китайского рынка и старых улочек. Музыкальная подложка — китайские народные мотивы, переходящие от лёгких и...
Gerador de imagens de uso geral da OpenAI: segue instruções longas e específicas, organiza textos e diagramas com clareza e pode retornar PNG ou WebP com fundo transparente para adesivos, ícones e recortes de produtos. Cinco níveis de qualidade equilibram velocidade e preço com detalhamento. Os tamanhos chegam a 3840 px na borda mais longa (múltiplos de 16, no máximo 3:1); até dez imagens por solicitação.
Envie o nome canônico ou o nome nativo, não ambos. Nomes canônicos
promptobrigatório
image_sizeopcional
backgroundopcional
qualityopcional
num_imagesopcional
num_outputs
output_formatopcional
output_compressionopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "openai/gpt-image-2.5/flare/text-to-image",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 13,
    "usd": "0.013",
    "charged": 13,
    "refunded": 0
  },
  "input": {
    "prompt": "A flat vector sticker of a smiling cactus wearing sunglasses, thick white outline, no background",
    "image_size": "square_hd",
    "quality": "medium",
    "background": "transparent"
  },
  "output": {
    "images": [
      {
        "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
        "content_type": "image/jpeg",
        "file_name": "0-output.jpeg",
        "file_size": 1843200,
        "width": 1024,
        "height": 768
      }
    ]
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}
Para agentes de IA: esta página em Markdown está em https://doitong.com/pt-BR/developers/models/openai/gpt-image-2.5/flare/text-to-image.md. Todos os modelos e guias: https://doitong.com/developers/llms.txt