Vídeo
Wan-2.2 Text-to-Video A14B with LoRAs Variantes: 3
≈ a partir de $ 0,507
507 créditos de API
Nenhum resultado. Tente “vídeo”, “FLUX” ou “webhooks”.
Carregando modelos…
wan/v2.2-a14b/text-to-image/lora
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/pt-BR/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.com/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
}Chame o modelo Wan v2.2 A14B Text-to-Image A14B with LoRAs (wan/v2.2-a14b/text-to-image/lora) por meio da Doitong API. Documentação para agentes: https://doitong.com/pt-BR/developers/models/wan/v2.2-a14b/text-to-image/lora.md
POST https://api.doitong.com/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
Se o status da resposta for "queued" ou "running", consulte GET https://api.doitong.com/v1/requests/REQUEST_ID?wait=20 repetidamente até que seja "succeeded"; os arquivos estão em outputs[].url. POST https://api.doitong.com/v1/quote/wan/v2.2-a14b/text-to-image/lora com o mesmo corpo retorna o preço exato antes da execução.Esta solicitação: $ 0,05 50 créditos de API Executar nesta página
Sua nova chave de API. Ela é exibida apenas agora e já está no código e no campo de chave de API abaixo. Mantenha-a em segredo: nunca a coloque em um código executado no navegador.
Trabalhos públicos feitos com Wan v22 LoRA pela comunidade Doitong. Reutilize um prompt com um clique.
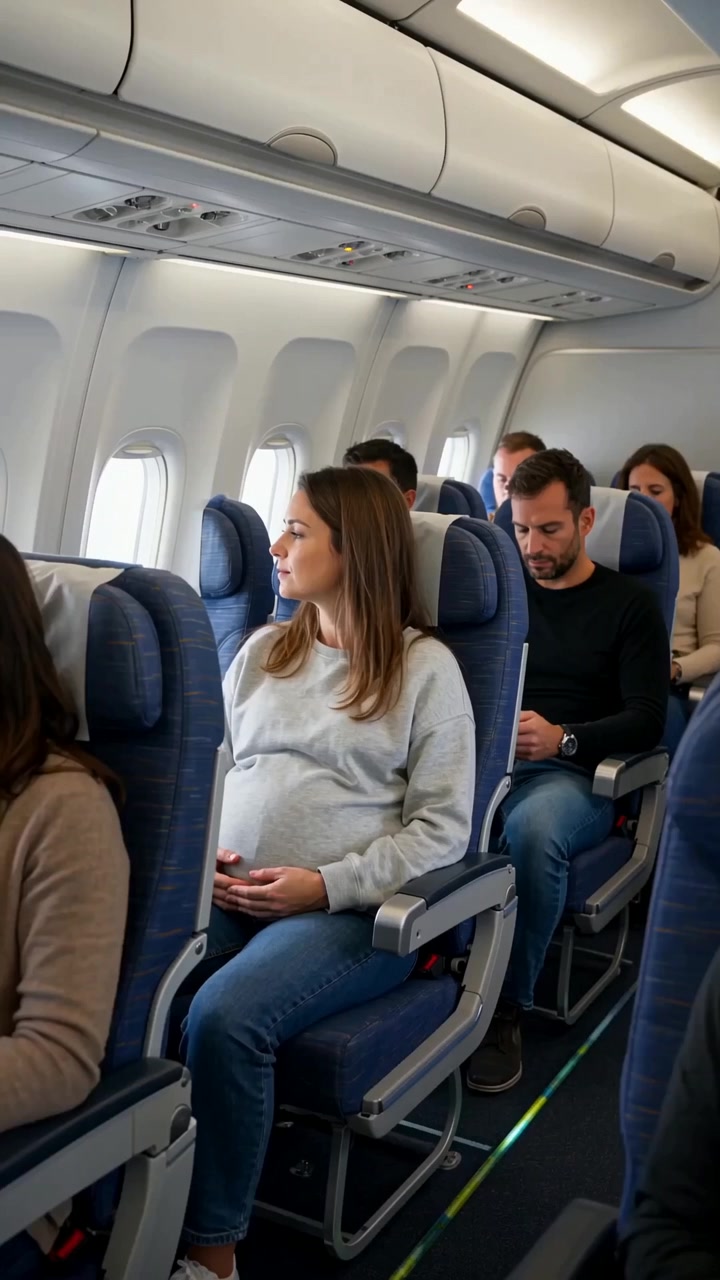 Vídeo
Create a realistic cinematic UGC-style commercial video, exactly 30 seconds long. The entire scene takes place inside a modern passenger airplane during a daytime flight. Natural smartphone-like cinematography, realistic airplane cabin, authentic passengers, natural lighting, realistic skin...
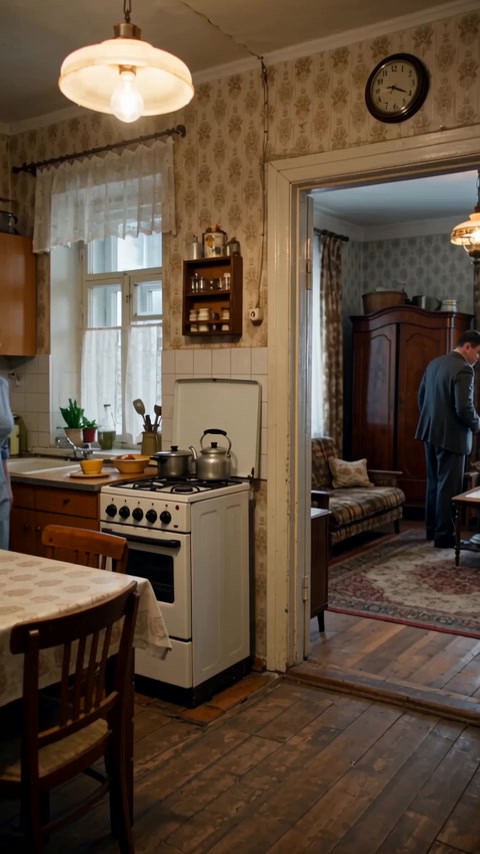 Vídeo
Реалистичная бытовая сцена в советской одесской квартире зимним вечером. Женщина находится на кухне, мужчина — в комнате и прихожей. Атмосфера обычной советской семьи перед приходом гостей. Голоса: все персонажи говорят по-русски с естественным, выразительным одесским говором. Характерная...
Os controles são gerados a partir do esquema do modelo. O código e o preço são atualizados conforme você os altera.
/run/wan/v2.2-a14b/text-to-image/lora?wait=20
cotação → $ 0,05
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/wan/v2.2-a14b/text-to-image/lora?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan/v2.2-a14b/text-to-image/lora?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan/v2.2-a14b/text-to-image/lora", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "wan/v2.2-a14b/text-to-image/lora",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
},
"wait_seconds": 20
}
}
}Sua chave permanece neste navegador: ela é enviada somente à Doitong API e salva (localStorage) apenas se você marcar Lembrar. Obter uma chave de API
Gera uma imagem a partir de um `prompt` e aplica pesos LoRA personalizados fornecidos em `loras`. `image_size` oferece predefinições quadrada, retrato e paisagem, e `image_format` é png ou jpeg. Também inclui `guidance_scale`, `guidance_scale_2`, `num_inference_steps` de até 40 e um `negative_prompt`.
promptobrigatório
negative_promptopcional
seedopcional
num_inference_stepsopcional
enable_safety_checkeropcional
enable_output_safety_checkeropcional
enable_prompt_expansionopcional
accelerationopcional
guidance_scaleopcional
guidance_scale_2opcional
shiftopcional
lorasopcional
loras[].pathobrigatório
loras[].weight_nameopcional
loras[].scaleopcional
loras[].transformeropcional
reverse_videoopcional
image_sizeopcional
image_formatopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "wan/v2.2-a14b/text-to-image/lora",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 50,
    "usd": "0.05",
    "charged": 50,
    "refunded": 0
  },
  "input": {
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  },
  "output": {
    "image": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "seed": 42
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}
Para agentes de IA: esta página em Markdown está em https://doitong.com/pt-BR/developers/models/wan/v2.2-a14b/text-to-image/lora.md. Todos os modelos e guias: https://doitong.com/developers/llms.txt