Video
Wan VACE 14B · Depth Varianti: 6
a partire da 0,04 $ / secondo di video in output
40 crediti API / secondo di video in output
Nessuna corrispondenza. Prova “video”, “FLUX” o “webhooks”.
Caricamento dei modelli…
wan-vace-14b
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/wan-vace-14b?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan-vace-14b?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan-vace-14b", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/it/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.com/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "wan-vace-14b",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
}Chiama il modello Wan VACE 14B (wan-vace-14b) tramite Doitong API. Documentazione per gli agenti: https://doitong.com/it/developers/models/wan-vace-14b.md
POST https://api.doitong.com/v1/run/wan-vace-14b?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}
Se lo stato della risposta è "queued" o "running", interroga GET https://api.doitong.com/v1/requests/REQUEST_ID?wait=20 finché non diventa "succeeded"; i file si trovano in outputs[].url. POST https://api.doitong.com/v1/quote/wan-vace-14b con lo stesso body restituisce il prezzo esatto prima dell'esecuzione.File come nell'esempio: 0,405 $ 405 crediti API i tuoi file vengono misurati prima dell'esecuzione Esegui in questa pagina
La tua nuova chiave API. Viene mostrata solo ora ed è già presente nel codice e nel campo della chiave API qui sotto. Mantienila segreta: non inserirla mai nel codice eseguito in un browser.
Lavori pubblici creati con Wan VACE 14B dalla community di Doitong. Riutilizza un prompt con un clic.
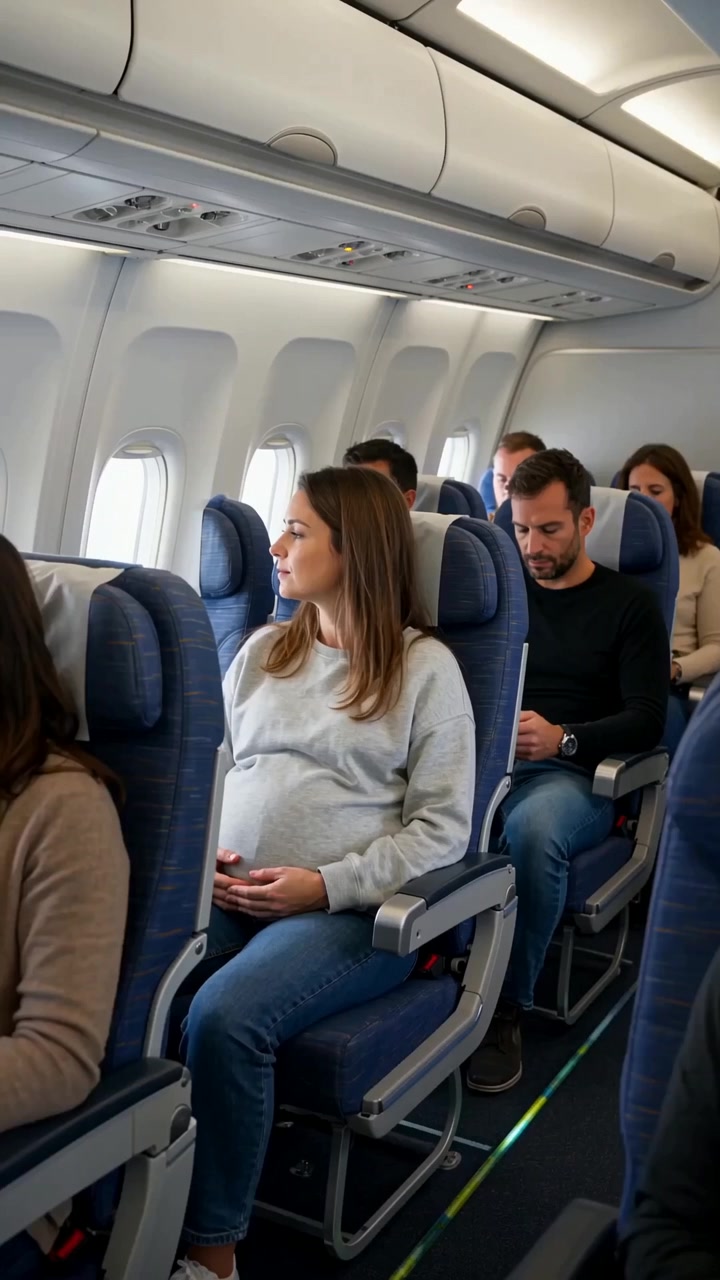 Video
Create a realistic cinematic UGC-style commercial video, exactly 30 seconds long. The entire scene takes place inside a modern passenger airplane during a daytime flight. Natural smartphone-like cinematography, realistic airplane cabin, authentic passengers, natural lighting, realistic skin...
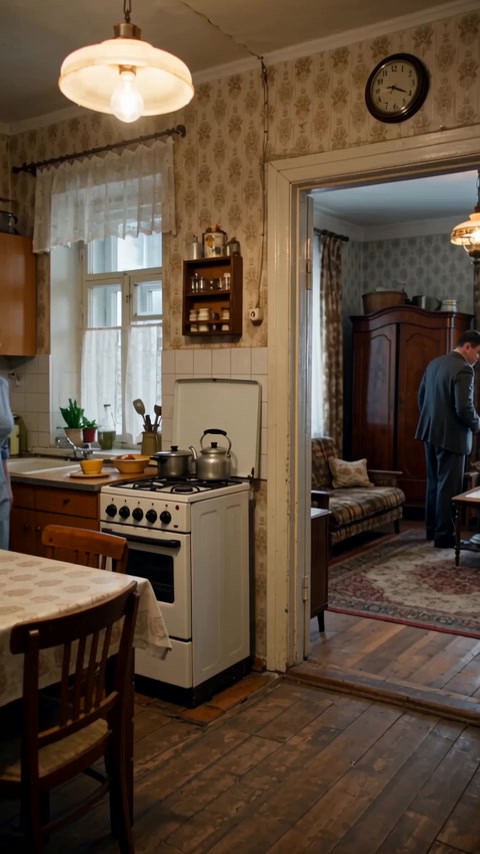 Video
Реалистичная бытовая сцена в советской одесской квартире зимним вечером. Женщина находится на кухне, мужчина — в комнате и прихожей. Атмосфера обычной советской семьи перед приходом гостей. Голоса: все персонажи говорят по-русски с естественным, выразительным одесским говором. Характерная...
I controlli vengono generati dallo schema del modello. Il codice e il prezzo si aggiornano mentre li modifichi.
/run/wan-vace-14b?wait=20
preventivo → 0,405 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/wan-vace-14b?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/wan-vace-14b?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/wan-vace-14b", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "wan-vace-14b",
"input": {
"prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
},
"wait_seconds": 20
}
}
}La tua chiave rimane in questo browser: viene inviata solo al Doitong API e salvata in localStorage solo se selezioni Ricorda. Ottieni una chiave API
Generatore ed editor video multiuso selezionato tramite `task`: mappa di profondità, posa, inpainting, outpainting o reframe. Gli input includono un `video_url` sorgente, un video o un'immagine maschera, `ref_image_urls` e gli URL del primo e dell'ultimo fotogramma. `num_frames` va da 17 a 241 e `resolution` da 240p a 720p. È possibile selezionare i campionatori unipc, dpm++ ed euler.
Invia il nome canonico oppure il nome nativo, non entrambi. Nomi canonici
promptobbligatorio
negative_promptfacoltativo
match_input_num_framesfacoltativo
num_framesfacoltativo
match_input_frames_per_secondfacoltativo
frames_per_secondfacoltativo
taskfacoltativo
seedfacoltativo
resolutionfacoltativo
aspect_ratiofacoltativo
num_inference_stepsfacoltativo
guidance_scalefacoltativo
samplerfacoltativo
shiftfacoltativo
video_urlfacoltativo
video
mask_video_urlfacoltativo
mask_image_urlfacoltativo
ref_image_urlsfacoltativo
first_frame_urlfacoltativo
image
last_frame_urlfacoltativo
end_image
enable_safety_checkerfacoltativo
enable_prompt_expansionfacoltativo
preprocessfacoltativo
accelerationfacoltativo
video_qualityfacoltativo
video_write_modefacoltativo
num_interpolated_framesfacoltativo
temporal_downsample_factorfacoltativo
enable_auto_downsamplefacoltativo
auto_downsample_min_fpsfacoltativo
interpolator_modelfacoltativo
transparency_modefacoltativo
return_frames_zipfacoltativo
I parametri file accettano un URL pubblico https://, un URI data: fino a 10 MB oppure il file_url di un caricamento. File
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "wan-vace-14b",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 405,
    "usd": "0.405",
    "charged": 405,
    "refunded": 0
  },
  "input": {
    "prompt": "A red fox trots through fresh snow at sunrise, soft golden light, shallow depth of field"
  },
  "output": {
    "video": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.mp4",
      "content_type": "video/mp4",
      "file_name": "0-output.mp4",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "fps": 1.0,
      "duration": 5,
      "num_frames": 1
    },
    "prompt": "string",
    "seed": 42,
    "frames_zip": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.mp4",
      "content_type": "video/mp4",
      "file_name": "0-output.mp4",
      "file_size": 1843200
    }
  },
  "outputs": [
    {
      "type": "video",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.mp4",
      "content_type": "video/mp4",
      "file_size": 1843200,
      "width": 1280,
      "height": 720,
      "duration": 5,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}Per gli agenti AI: questa pagina in Markdown è disponibile all'indirizzo https://doitong.com/it/developers/models/wan-vace-14b.md. Tutti i modelli e le guide: https://doitong.com/developers/llms.txt