Archivo
MiniMax H3 First Last Frame LoRA Trainer Variantes: 4
0,01 $ / paso
10 créditos de API / paso
No hay coincidencias. Prueba con “video”, “FLUX” o “webhooks”.
Cargando modelos…
minimax/h3/ref2va/trainer
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/minimax/h3/ref2va/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/ref2va/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/ref2va/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/es/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.com/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "minimax/h3/ref2va/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
}
}Llama al modelo MiniMax H3 Reference to Video LoRA Trainer (minimax/h3/ref2va/trainer) mediante Doitong API. Documentación para agentes: https://doitong.com/es/developers/models/minimax/h3/ref2va/trainer.md
POST https://api.doitong.com/v1/run/minimax/h3/ref2va/trainer?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"training_data_url": "https://example.com/your-file.zip"
}
Si el estado de la respuesta es "queued" o "running", consulta GET https://api.doitong.com/v1/requests/REQUEST_ID?wait=20 hasta que sea "succeeded"; los archivos están en outputs[].url. POST https://api.doitong.com/v1/quote/minimax/h3/ref2va/trainer con el mismo cuerpo devuelve el precio exacto antes de la ejecución.Esta solicitud: 30,00 $ 30.000 créditos de API Ejecutar en esta página
Tu nueva clave de API. Solo se muestra ahora y ya está en el código y en el campo de clave de API de abajo. Mantenla en secreto: nunca la incluyas en código que se ejecute en un navegador.
Trabajos públicos creados con MiniMax H3 por la comunidad de Doitong. Reutiliza un prompt con un clic.
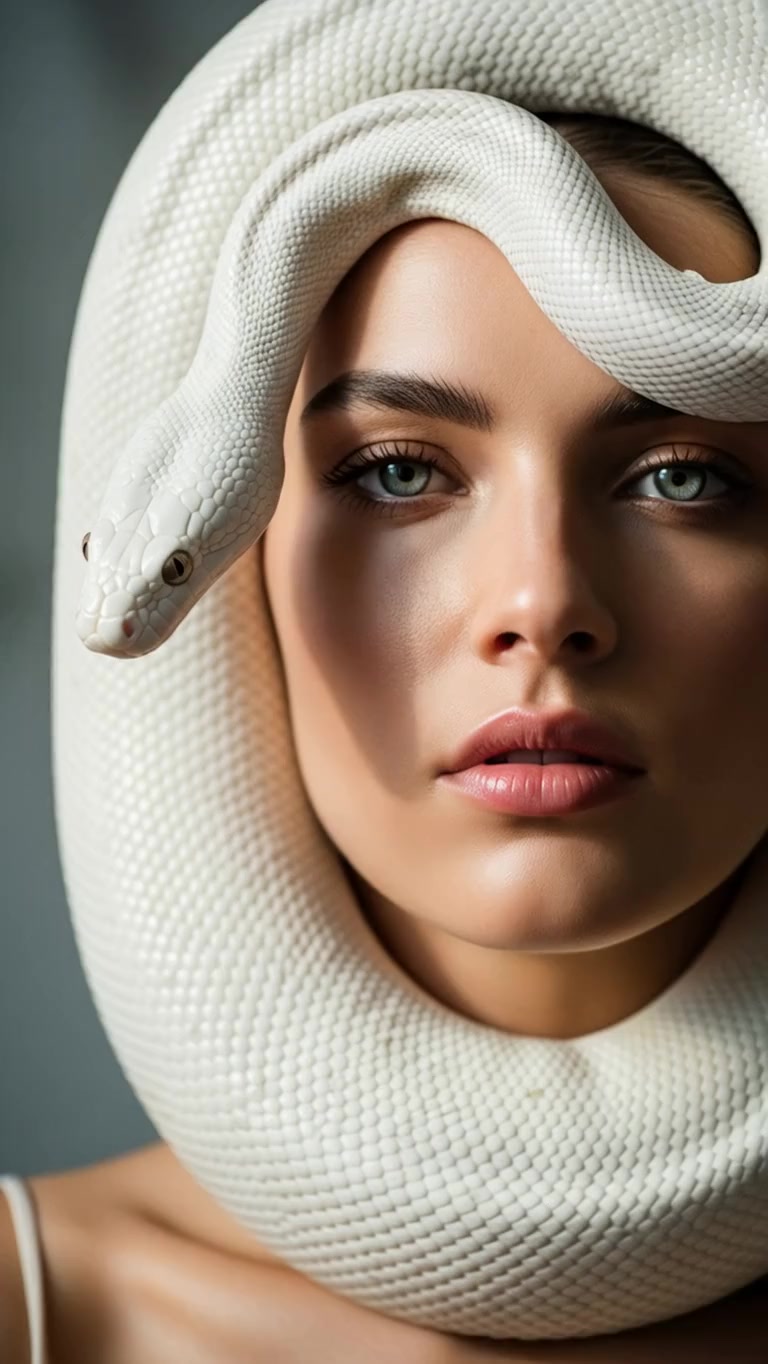 Vídeo
Close-up shot of a striking model with piercing eyes and flawless skin, a white snake elegantly coiled around her head and neck, its scales glistening in soft, diffused light. The camera gently zooms in, emphasizing the intricate texture of the snake’s scales and the model’s striking facial...
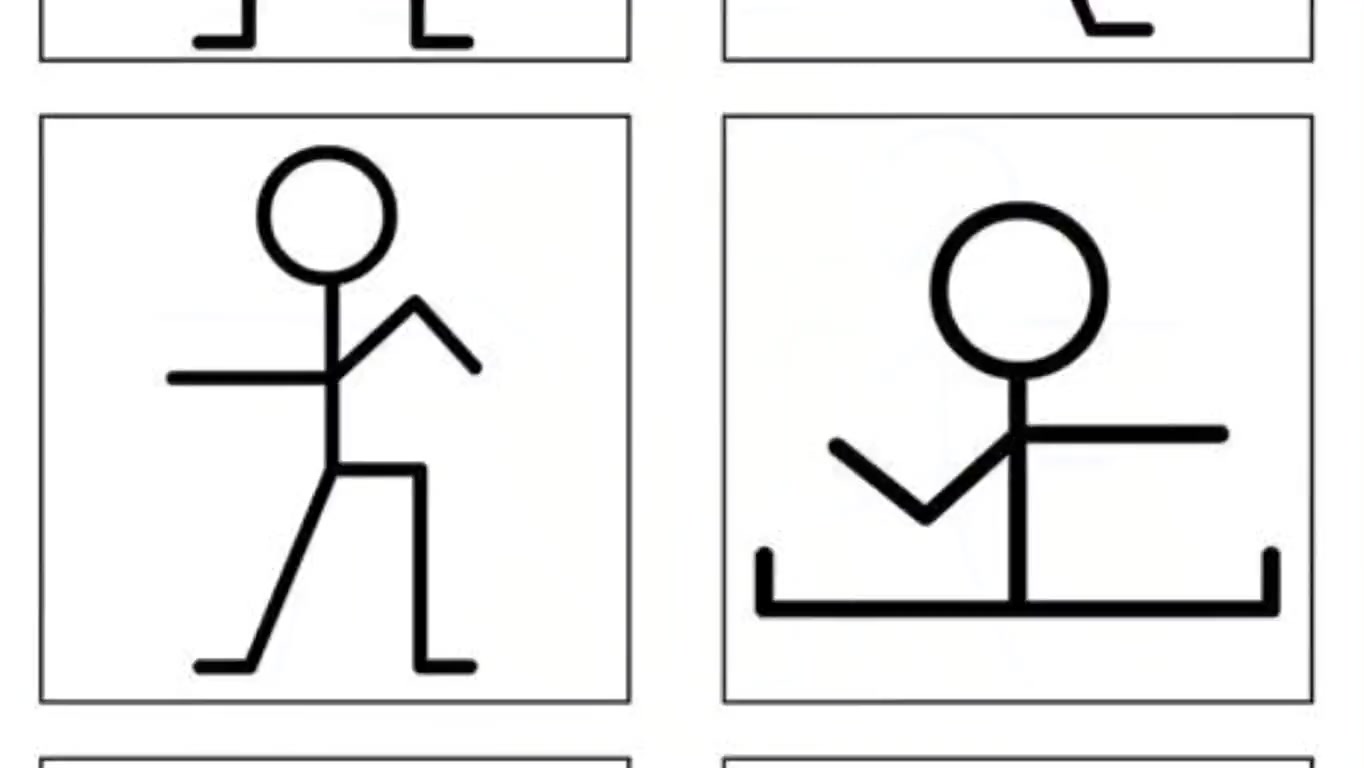 Vídeo
Animate the stickman drawings into a smooth dance animation. The simple black stick figure performs fun rhythmic dance moves — waving its arms, bending knees, jumping lightly, spinning, and swaying side to side in time with upbeat music. Keep the white background clean and minimal. The motion...
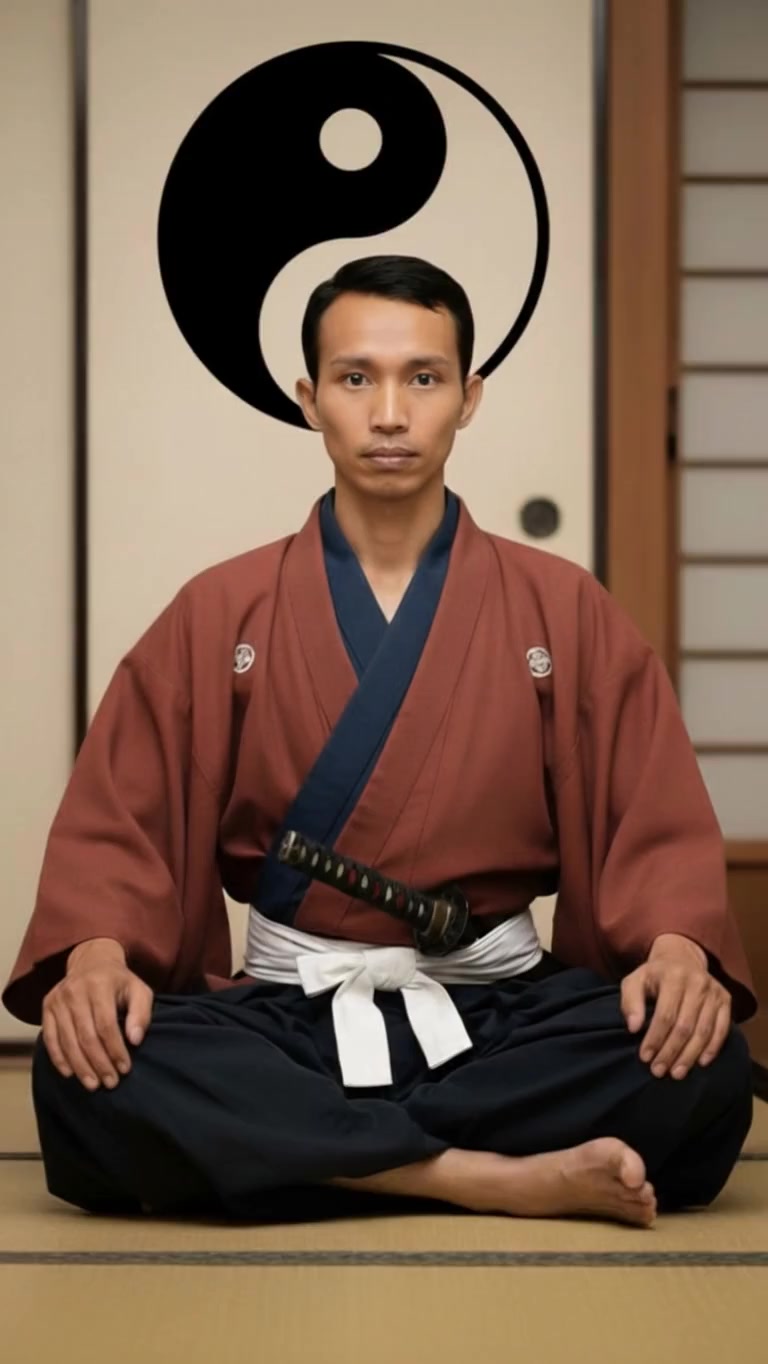 Vídeo
A hyper-realistic, cinematic transformation sequence of the man in the uploaded image, sitting in meditation inside a traditional Japanese room. The atmosphere begins to tremble slightly as soft blue light flows around him. From the ground, thousands of magnetic nano-particles rise, shimmering...
 Vídeo
A cinematic transformation video of the man. The scene begins with him standing naturally, then looking down at his hands as glowing holographic projections appear around his body. Mechanical parts of the Iron Man armor start assembling piece by piece with smooth animation: chest plate forming,...
 Vídeo
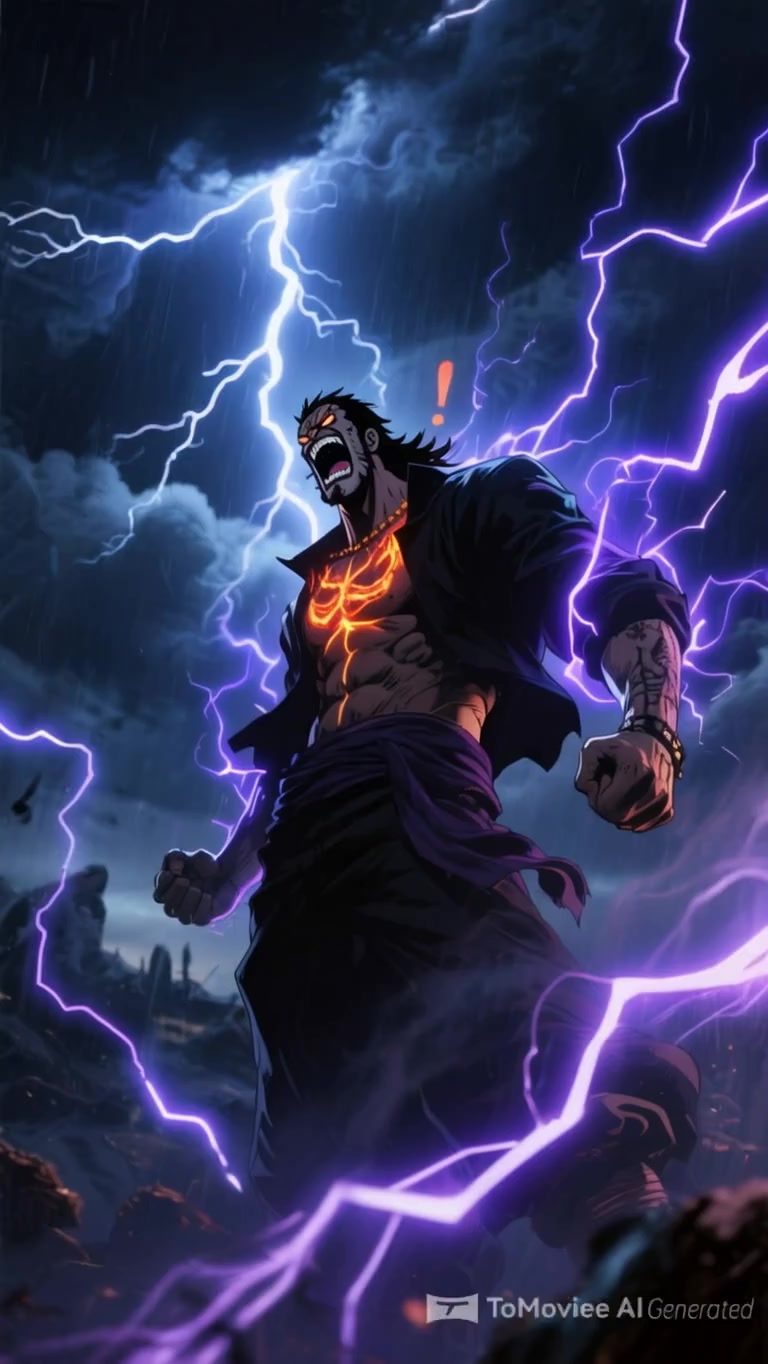
An ultra-epic anime cinematic of Luffy’s greatest enemy unleashing a terrifying blind rage, rampaging uncontrollably against nature itself. His gigantic body is surrounded by a storm of black and crimson energy, crackling with lightning that scorches the ground. His roar shakes the heavens,...
 Vídeo
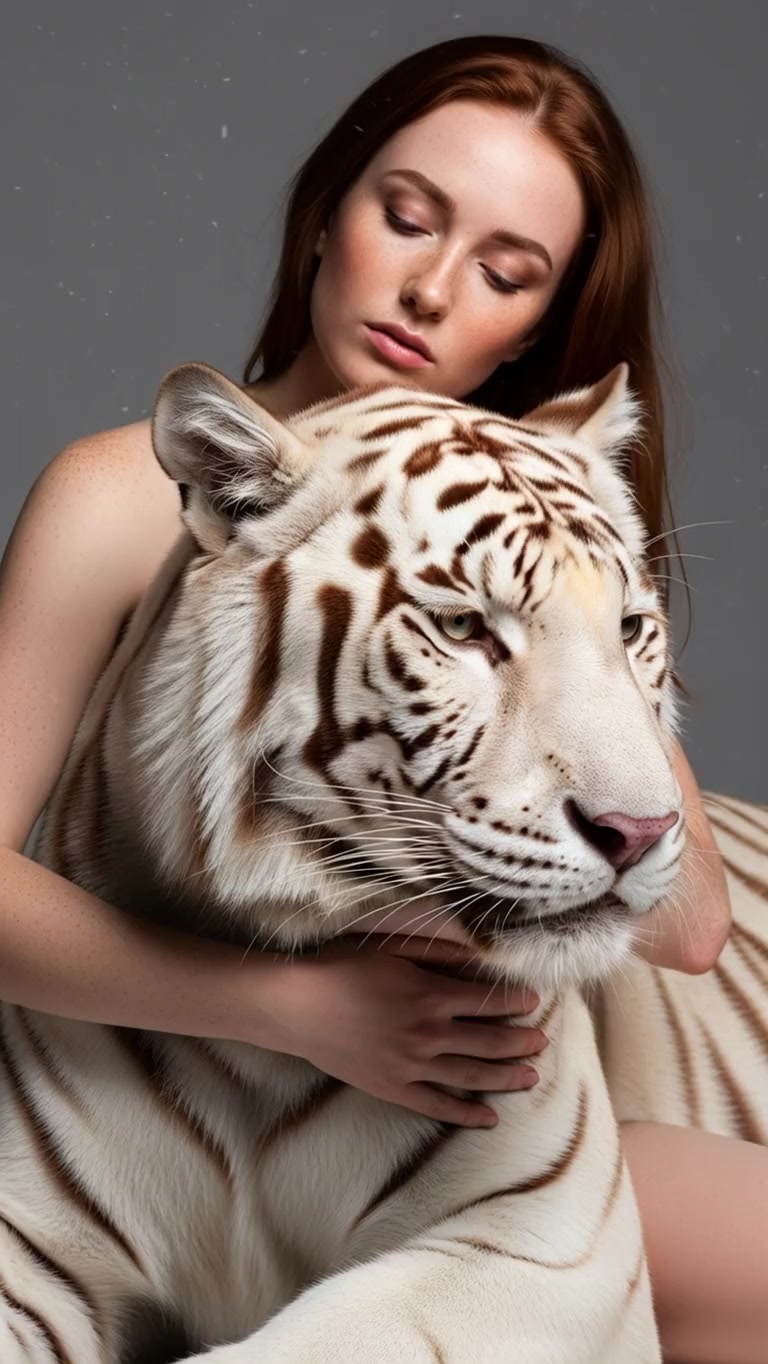
A fair-skinned red-haired woman with freckles tightly embraces a majestic white tiger with faint reddish stripes. They remain close, perfectly synchronized in stillness. The woman blinks slowly, slightly tilting her head with a serious and intense expression. The tiger breathes gently — its...
 Vídeo
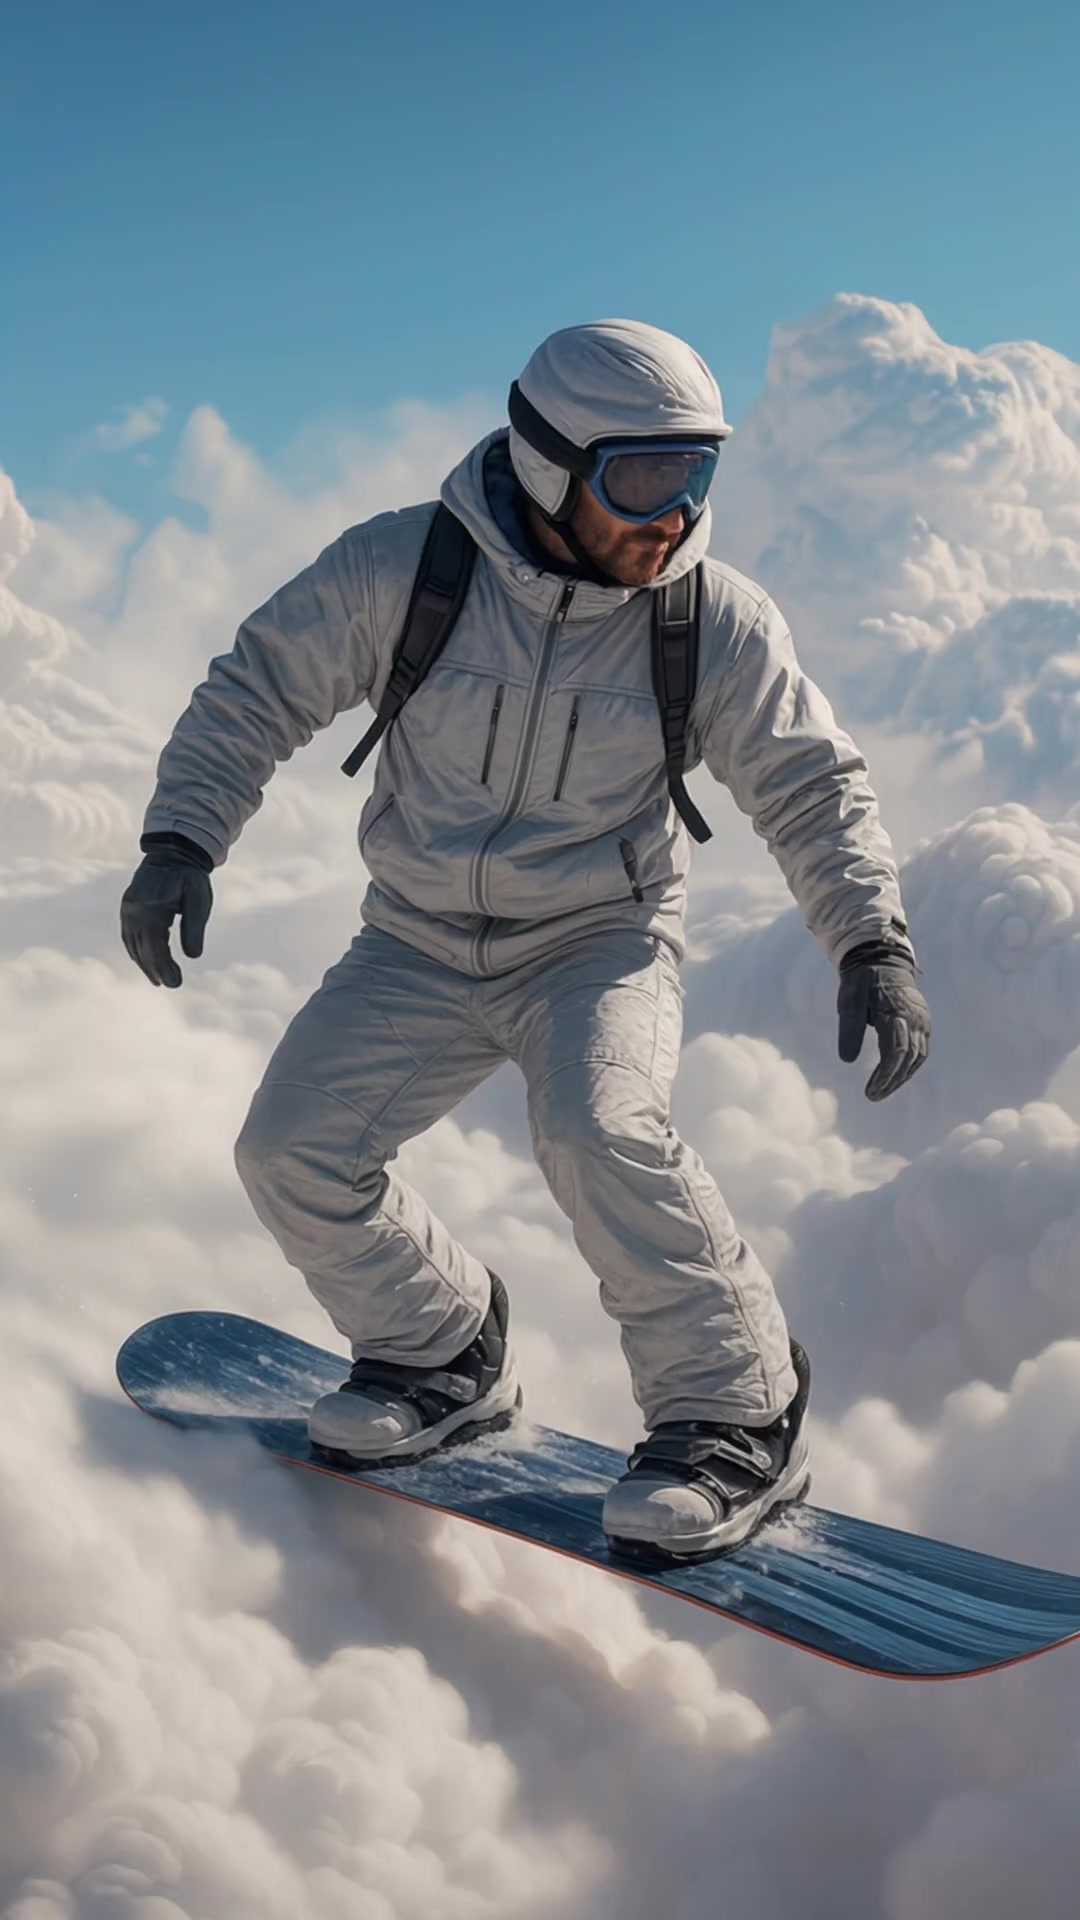
The snowboarder is riding across massive, fluffy white clouds as if they were snow-covered mountains, with dramatic lighting and deep shadows adding volume and realism. The background shows a stunning blue sky with scattered soft clouds and subtle light rays. crisp cinematic quality, vivid...
 Vídeo
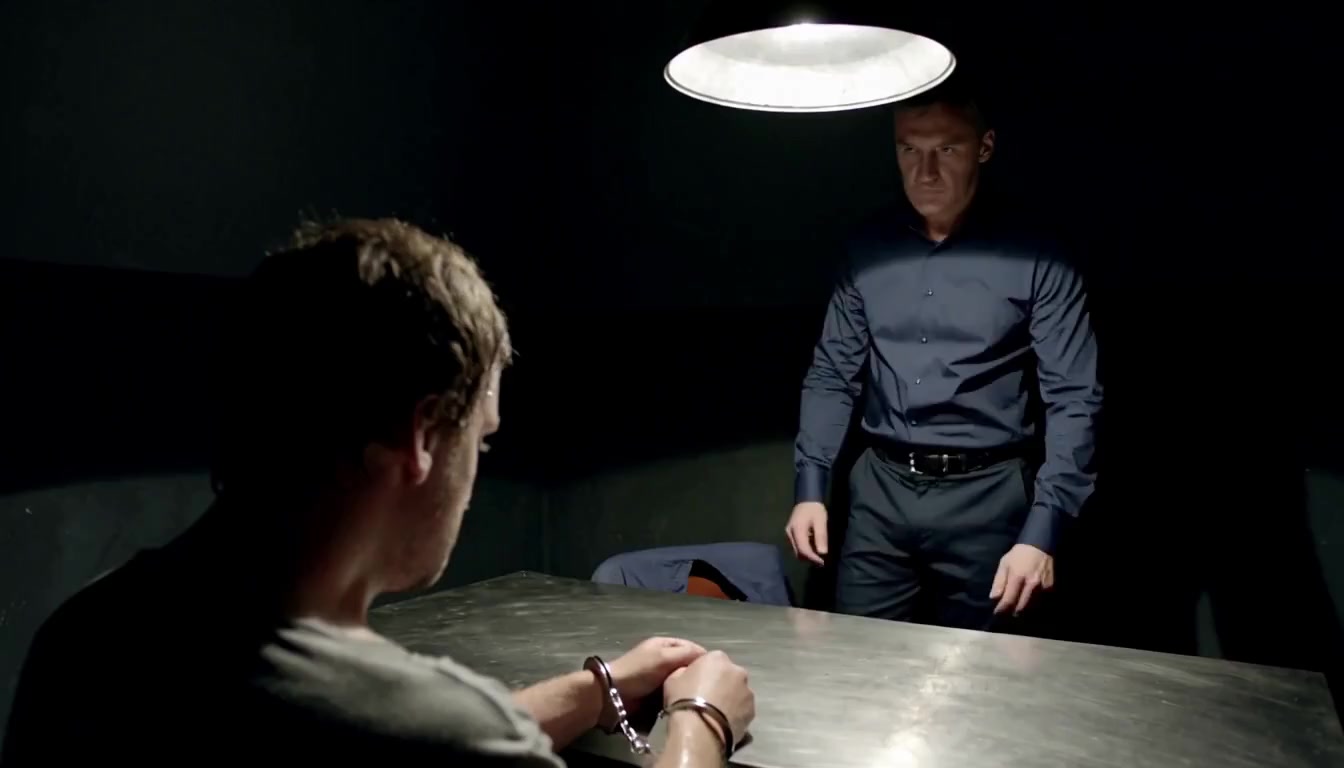
Мрачная комната для допросов, тесная и давящая. Одна резкая лампа под потолком бросает конус холодного света на металлический стол, вокруг густые тени. Виновный подозреваемый сидит в наручниках по одну сторону стола: потеет, нервно бегает глазами, тяжело дышит, избегает взгляда. Напротив —...
Изящная женщина в струящемся темном платье до пола с пышными, объемными волосами. Контекст: Сюрреалистический, похожее на сон пространство, залитое высококонтрастным освещением, с ярким, сияющим вертикальным лучом света вдали. Действие: Женщина очень медленно идет от камеры к яркому свету. Ее...
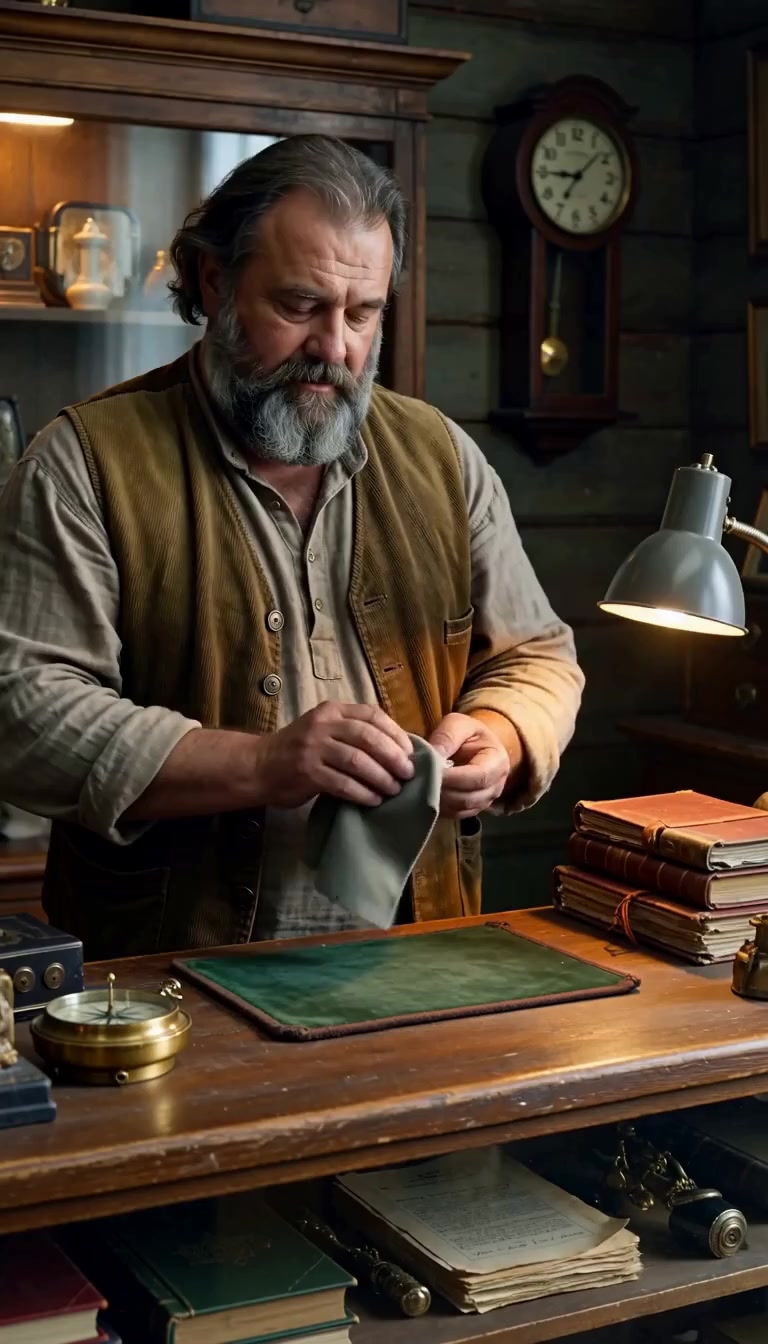 Vídeo
Model: Hailuo AI / MiniMax Video-01 Language: Russian (all dialogue and on-screen text in Russian) Aspect ratio: 9:16 vertical Resolution: 1080×1920 Frame rate: 24fps cinematic Style: photorealistic, shot on Sony FX3, natural light + practical sources Color grade: warm shadows, slightly...
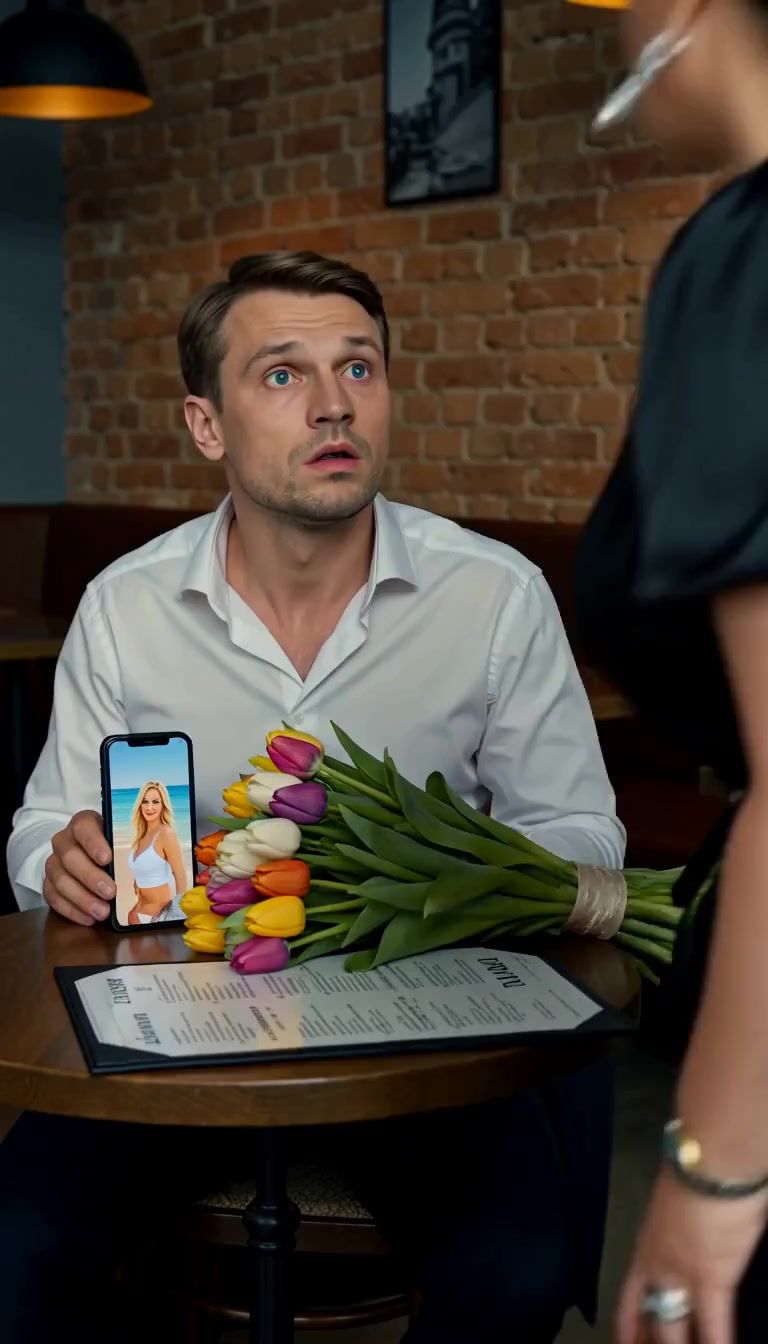 Vídeo
СВИДАНИЕ» ━━━━━━━━━━━━━━━━━━━━━━━━━━━━ [0:00–0:12] ХУК [СЦЕНА: Кафе. СЛАВА, 31, айтишник в свежей рубашке. Букет. Телефон на столе — на экране фото: девушка 22, пляж, модель.] [ДЕЙСТВИЕ: Подходит ОЛЯ. 43, в теле, красная помада, взгляд человека, которого невозможно смутить. Садится. Пододвигает к...
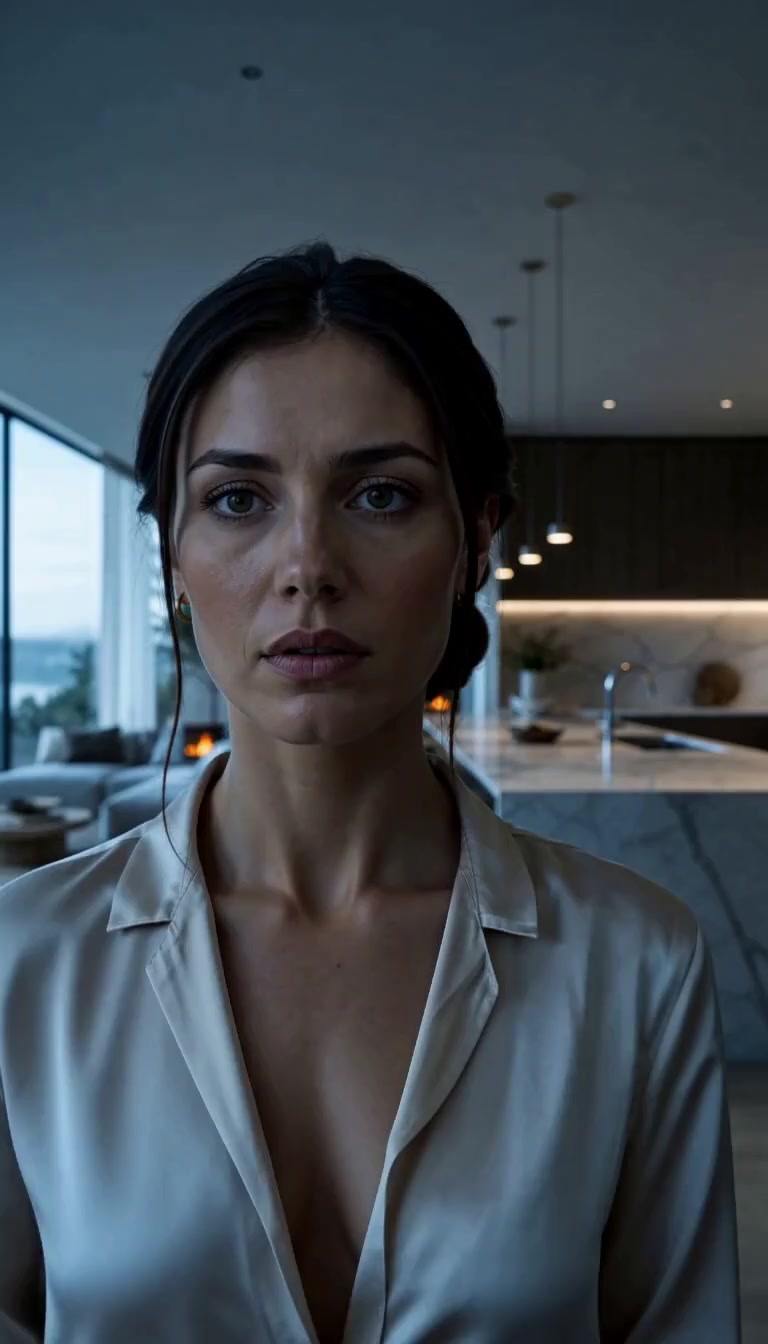 Vídeo
A 28-year-old dark-haired woman slowly picks up a smartphone, her shocked face reflected in the dark screen. Slow dolly-in on her face, cold morning light, tense silence, cinematic realism, shallow depth of field, vertical 9:16. She speaks in Russian, quietly and shaken: «Даниэль… чей это номер?»...
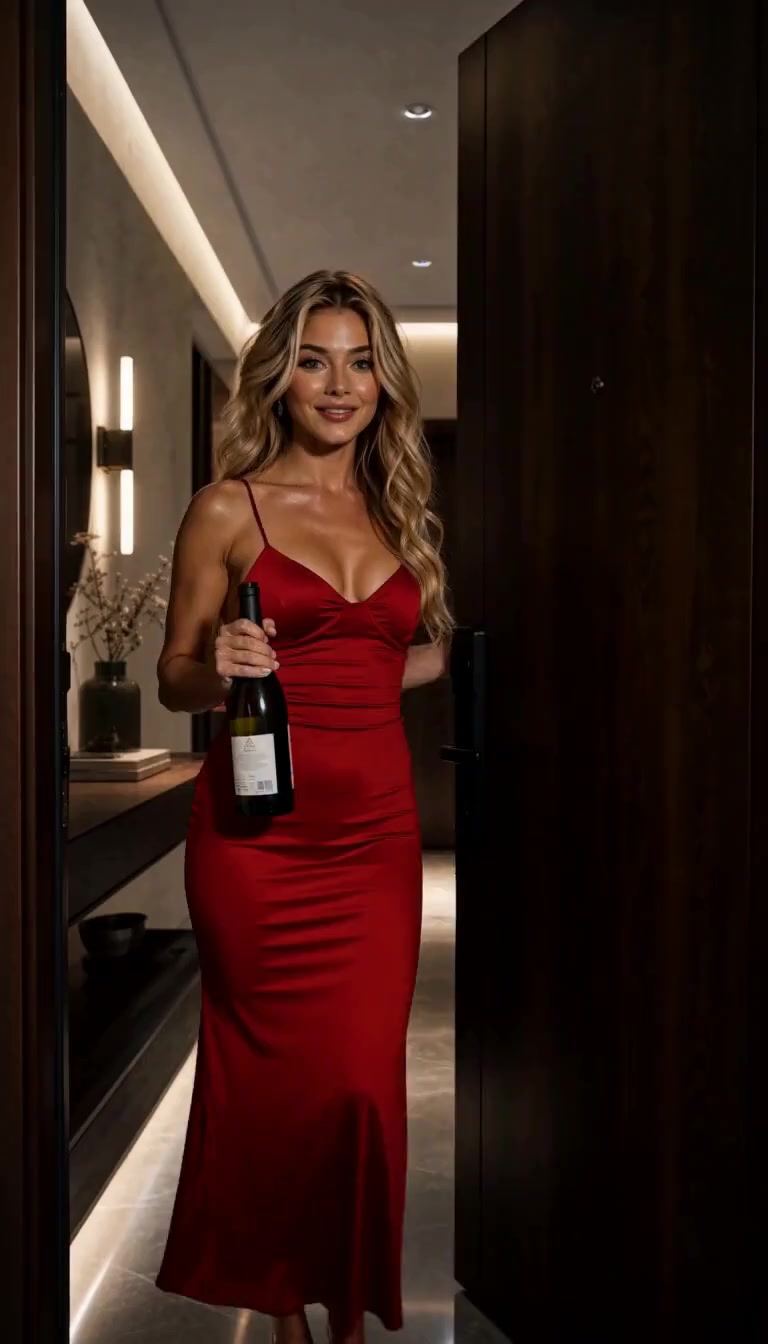 Vídeo
A 26-year-old blonde woman in a red dress stands at an open apartment doorway holding a bottle of wine, smiling brightly. Medium shot, warm hallway light, hidden tension, cinematic realism, vertical 9:16. She speaks in Russian, cheerful and sweet: «Привет, дорогая! Я так соскучилась!» The...
 Vídeo
The apartment front door opens and a man in a suit freezes, seeing both women. The dark-haired woman's phone vibrates with a new message. She looks directly into the camera with an unreadable expression. Slow dramatic push-in on her eyes, screen fades to black. Cinematic, tense cliffhanger mood,...
Art style: warm European aesthetic, golden hour light, soft bokeh, intimate close-ups, film grain, muted warm tones. Мужчина и женщина медленно идут по брусчатке, держась за руки, останавливаются у цветочной лавки. Мужчина аккуратно берет один цветок и с искренней улыбкой протягивает его...
Art style: warm European aesthetic, golden hour light, soft bokeh, intimate close-ups, film grain, muted warm tones. Женщина выходит в прихожую со словами: «Моника, кто там?», затем видит гостя, мягко произносит: «Заходи.». Мужчина делает нерешительный шаг вперед и с заметной легкой дрожью в руке...
Los controles se generan a partir del esquema del modelo. El código y el precio se actualizan al modificarlos.
/run/minimax/h3/ref2va/trainer?wait=20
cotización → 30,00 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/minimax/h3/ref2va/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/ref2va/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/ref2va/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "minimax/h3/ref2va/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
},
"wait_seconds": 20
}
}
}Tu clave permanece en este navegador: solo se envía a la Doitong API y se guarda (localStorage) únicamente si marcas Recordar. Obtener una clave de API
Entrena una LoRA con un zip de clips de video de sujetos para que las entradas de referencia guíen la generación de video. `reference_conditioning_p` establece con qué frecuencia se usan las referencias durante el entrenamiento, y `resume_from_lora_url` continúa desde una LoRA entrenada anteriormente. También se pueden configurar `rank`, `number_of_steps`, `number_of_frames`, `frame_rate` y `aspect_ratio`. Devuelve los pesos y un archivo de configuración.
training_data_urlobligatorio
rankopcional
number_of_stepsopcional
learning_rateopcional
number_of_framesopcional
frame_rateopcional
resolutionopcional
aspect_ratioopcional
trigger_phraseopcional
reference_conditioning_popcional
resume_from_lora_urlopcional
auto_scale_inputopcional
split_input_into_scenesopcional
split_input_duration_thresholdopcional
debug_datasetopcional
strict_datasetopcional
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "minimax/h3/ref2va/trainer",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 30000,
    "usd": "30.00",
    "charged": 30000,
    "refunded": 0
  },
  "input": {
    "training_data_url": "https://example.com/your-file.zip"
  },
  "output": {
    "lora_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "config_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "debug_dataset": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    }
  },
  "outputs": [
    {
      "type": "file",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}Para agentes de IA: esta página en Markdown está en https://doitong.com/es/developers/models/minimax/h3/ref2va/trainer.md. Todos los modelos y guías: https://doitong.com/developers/llms.txt